本文由AI整理自一份 DRAM 学习演示文稿,重点围绕 DDR、LPDDR、GDDR、HBM 四种内存标准展开对比。文中插图均为原演示文稿页面;演示文稿备注中的补充信息已尽量融入正文。
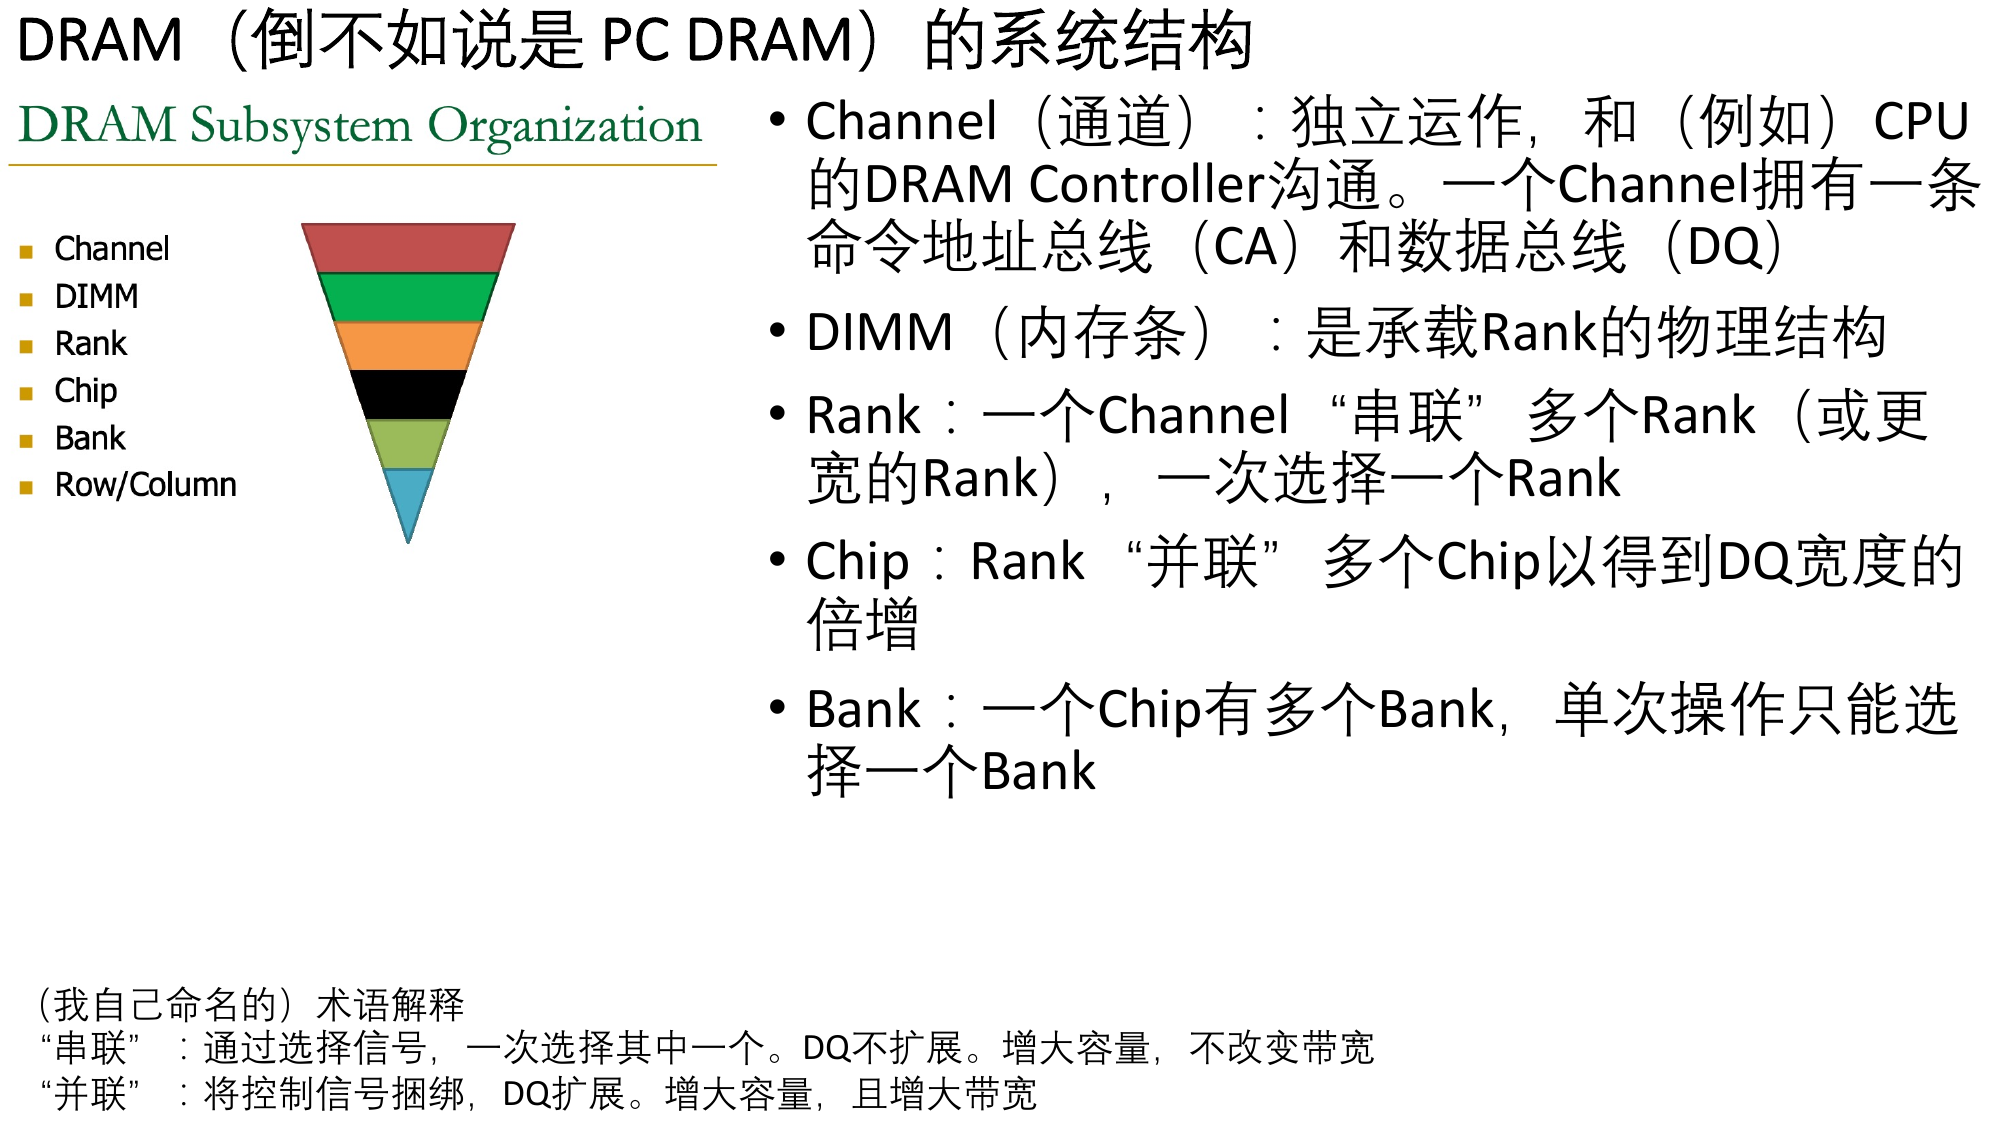
想要看懂四种标准的差异,需要先熟悉几个反复出现的概念:Channel、DIMM、Rank、Chip、Bank。它们的层次关系可以这样理解:Channel(通道)独立运作,与 CPU 的 DRAM 控制器通信,拥有一条命令地址总线(CA)和一条数据总线(DQ);DIMM(内存条)是承载 Rank 的物理结构;一个 Channel 通过选择信号“串联”多个 Rank,一次只选一个;一个 Rank 内再“并联”多颗 DRAM 芯片,使 DQ 总宽度成倍增加;而一颗芯片内部有多个 Bank,单次操作只能选择其中一个。
这里需要说明原演示文稿对“串联”和“并联”的特别用法:串联指通过选择信号一次启用其中之一,DQ 不扩展,增大容量但不改变带宽;并联则把控制信号捆绑在一起,DQ 得以扩展,容量和带宽同时增加。
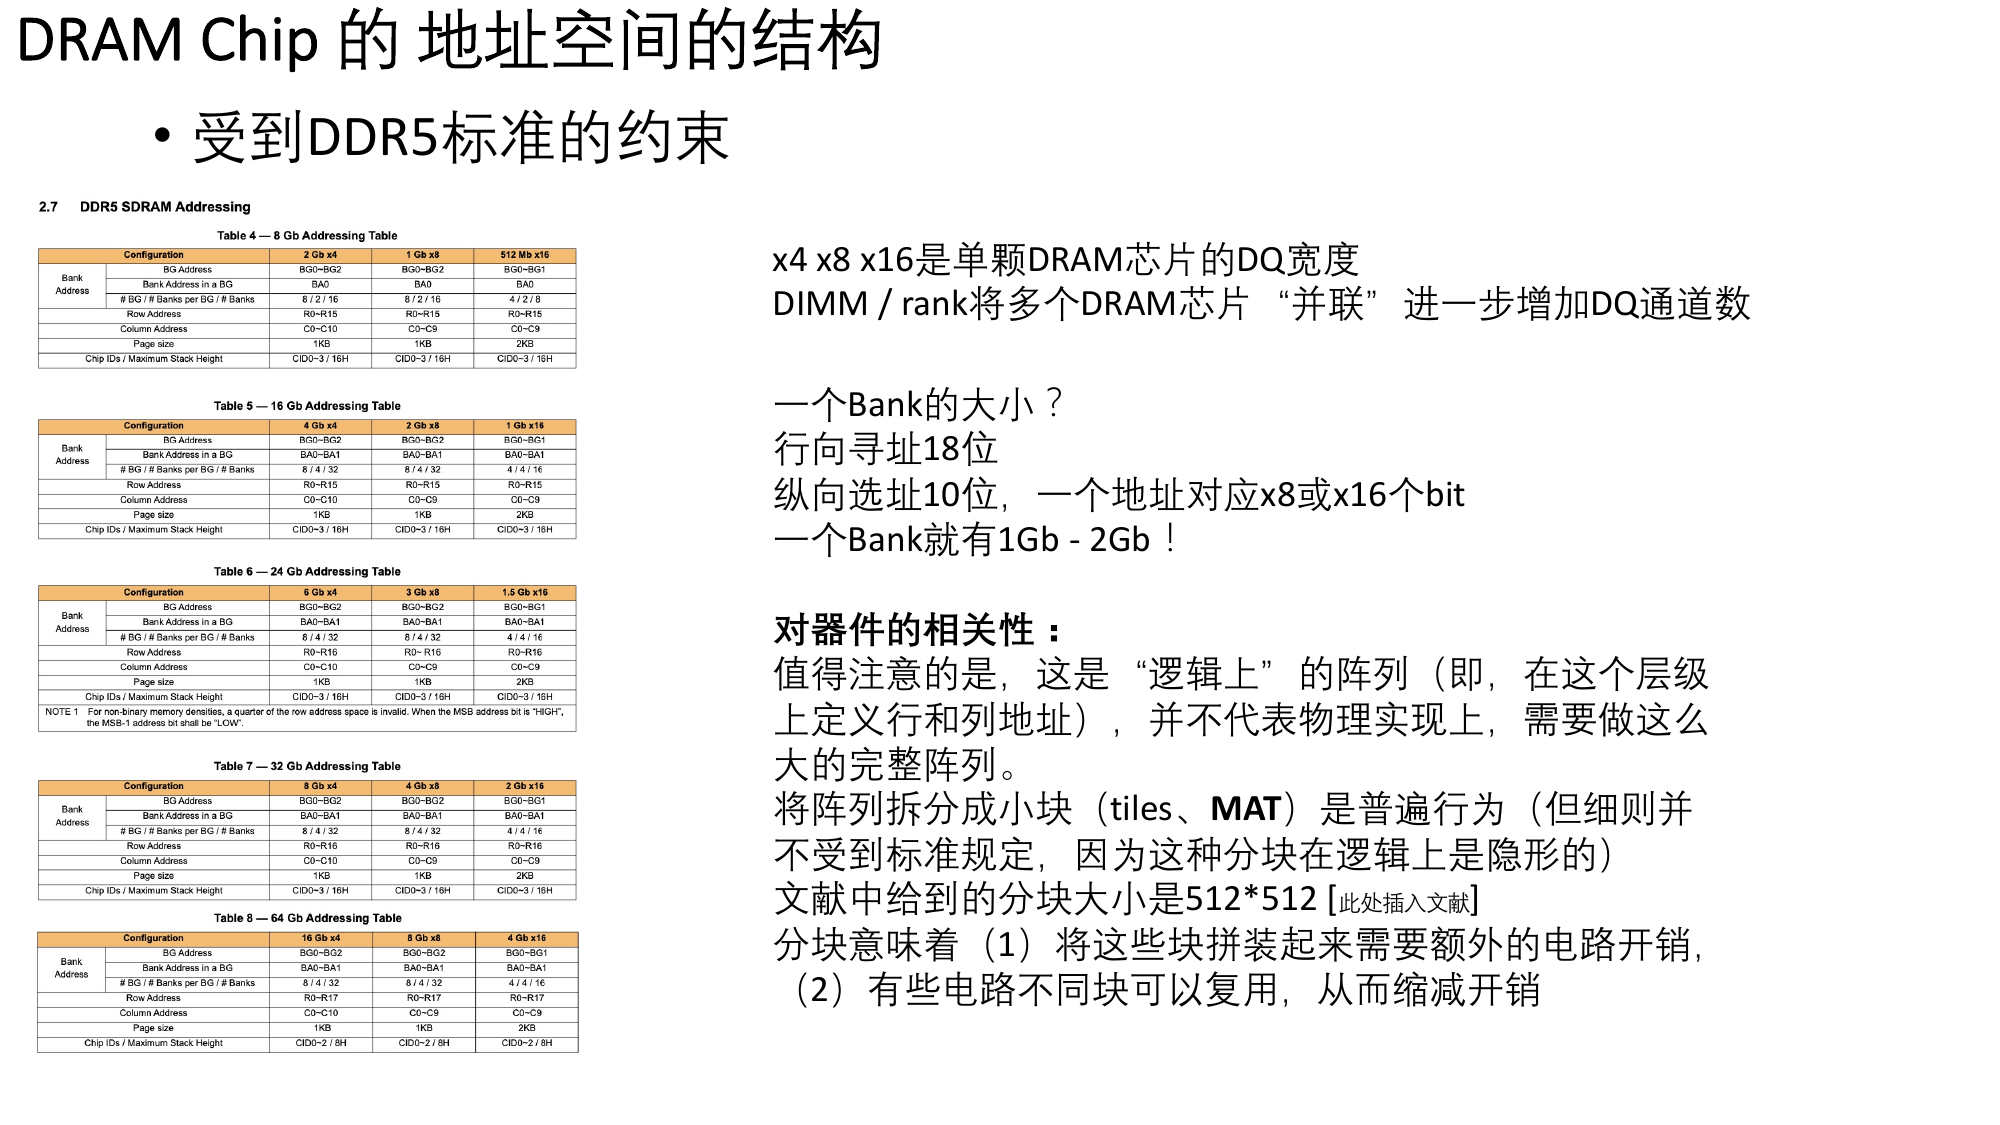
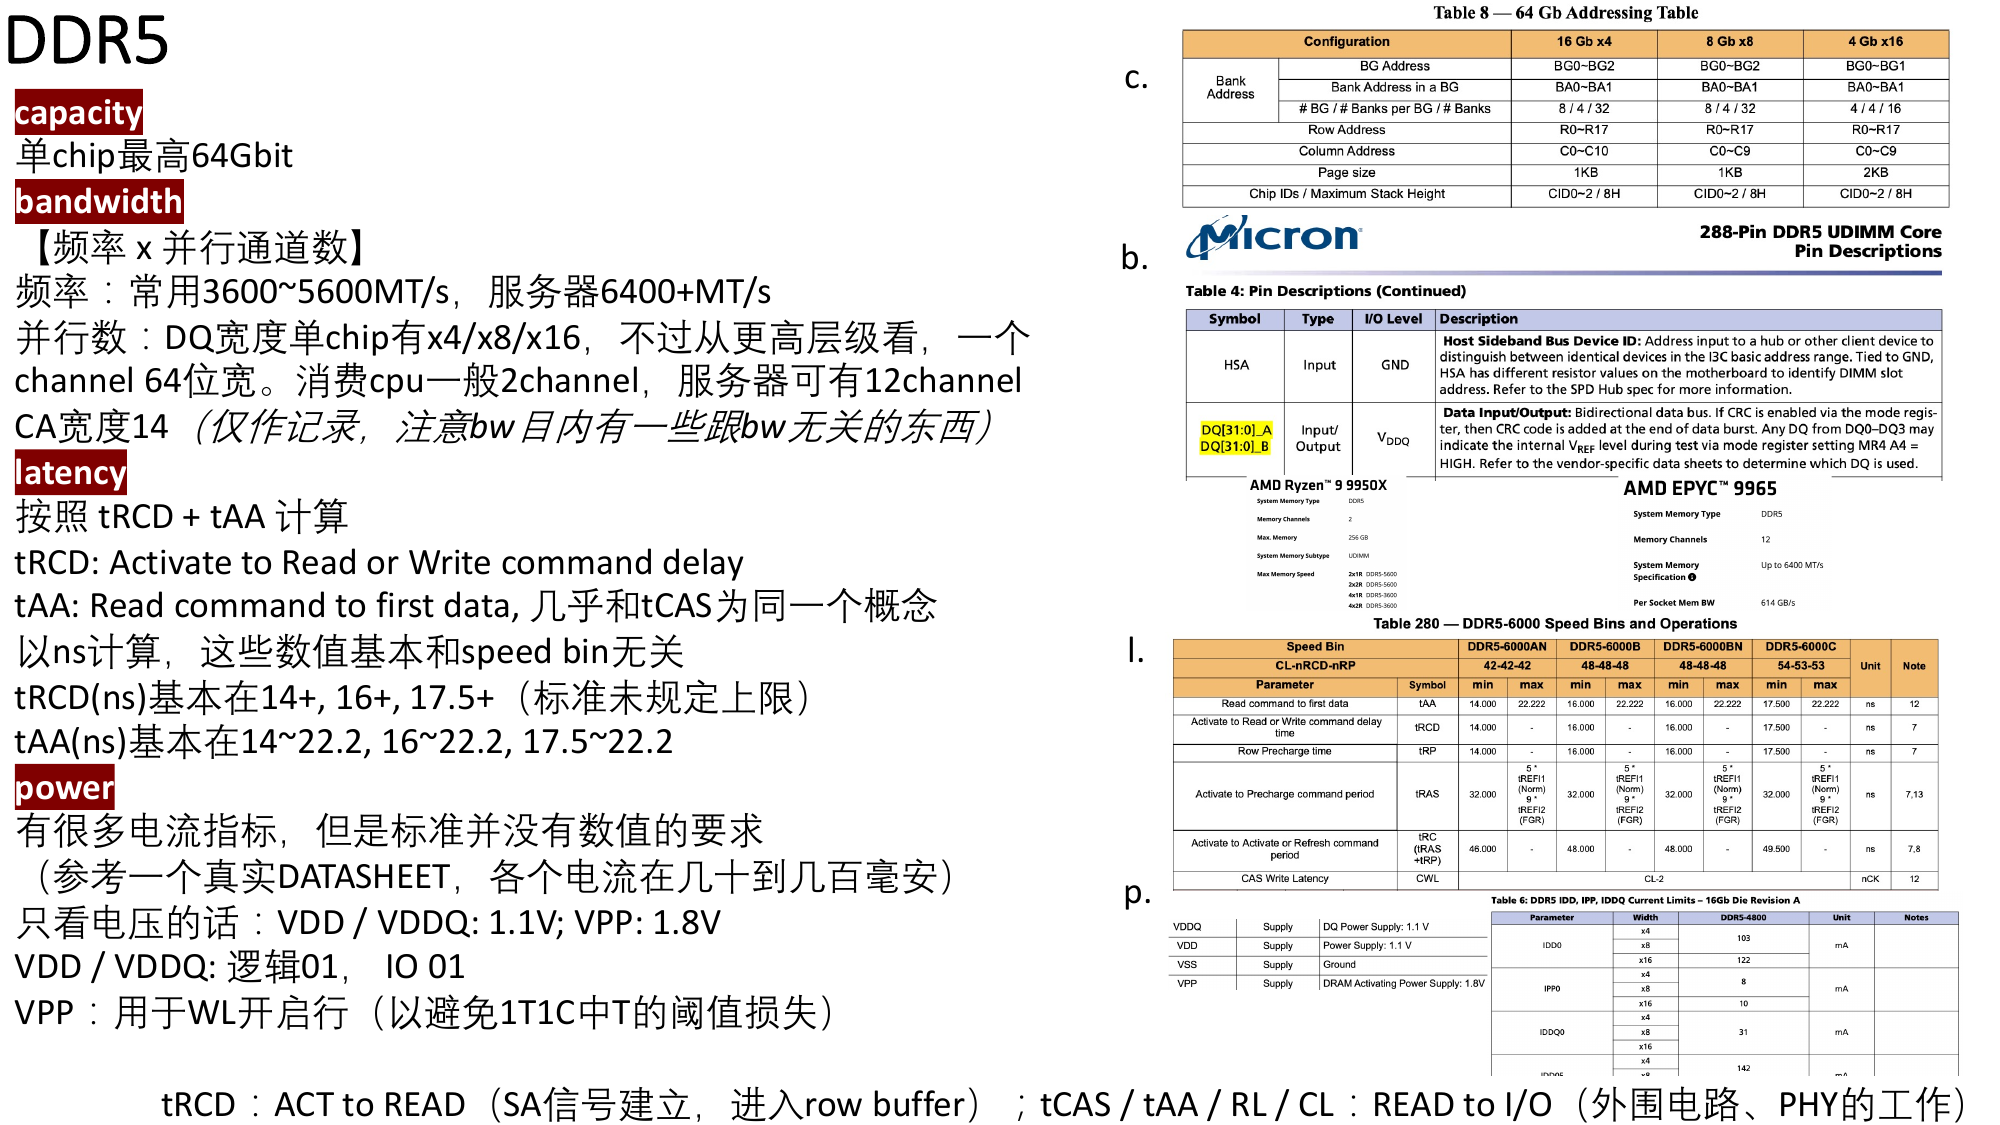
DRAM 芯片的地址空间结构受 DDR5 标准约束。x4、x8、x16 指的是单颗芯片的 DQ 宽度,DIMM/Rank 把多颗芯片“并联”起来,进一步增加 DQ 通道数。以行向 18 位、列向 10 位寻址计算,一个 Bank 的大小可以达到 1~2 Gb——不过这只是逻辑上的阵列。物理实现中,通常会把大阵列拆分成小块(tiles/MAT),文献中常见 512×512 的分块:分块一方面带来拼装所需的额外电路开销,另一方面也让部分电路可以在不同块之间复用,从而缩减总开销。
DDR5 相比 DDR4 最直观的变化在于通道划分:DDR4 一个 DIMM 对应一个 x64 的 Channel,而 DDR5 一个 DIMM 对应两个 x32 的 Sub-channel。通道变窄但数量变多,调度更加灵活。
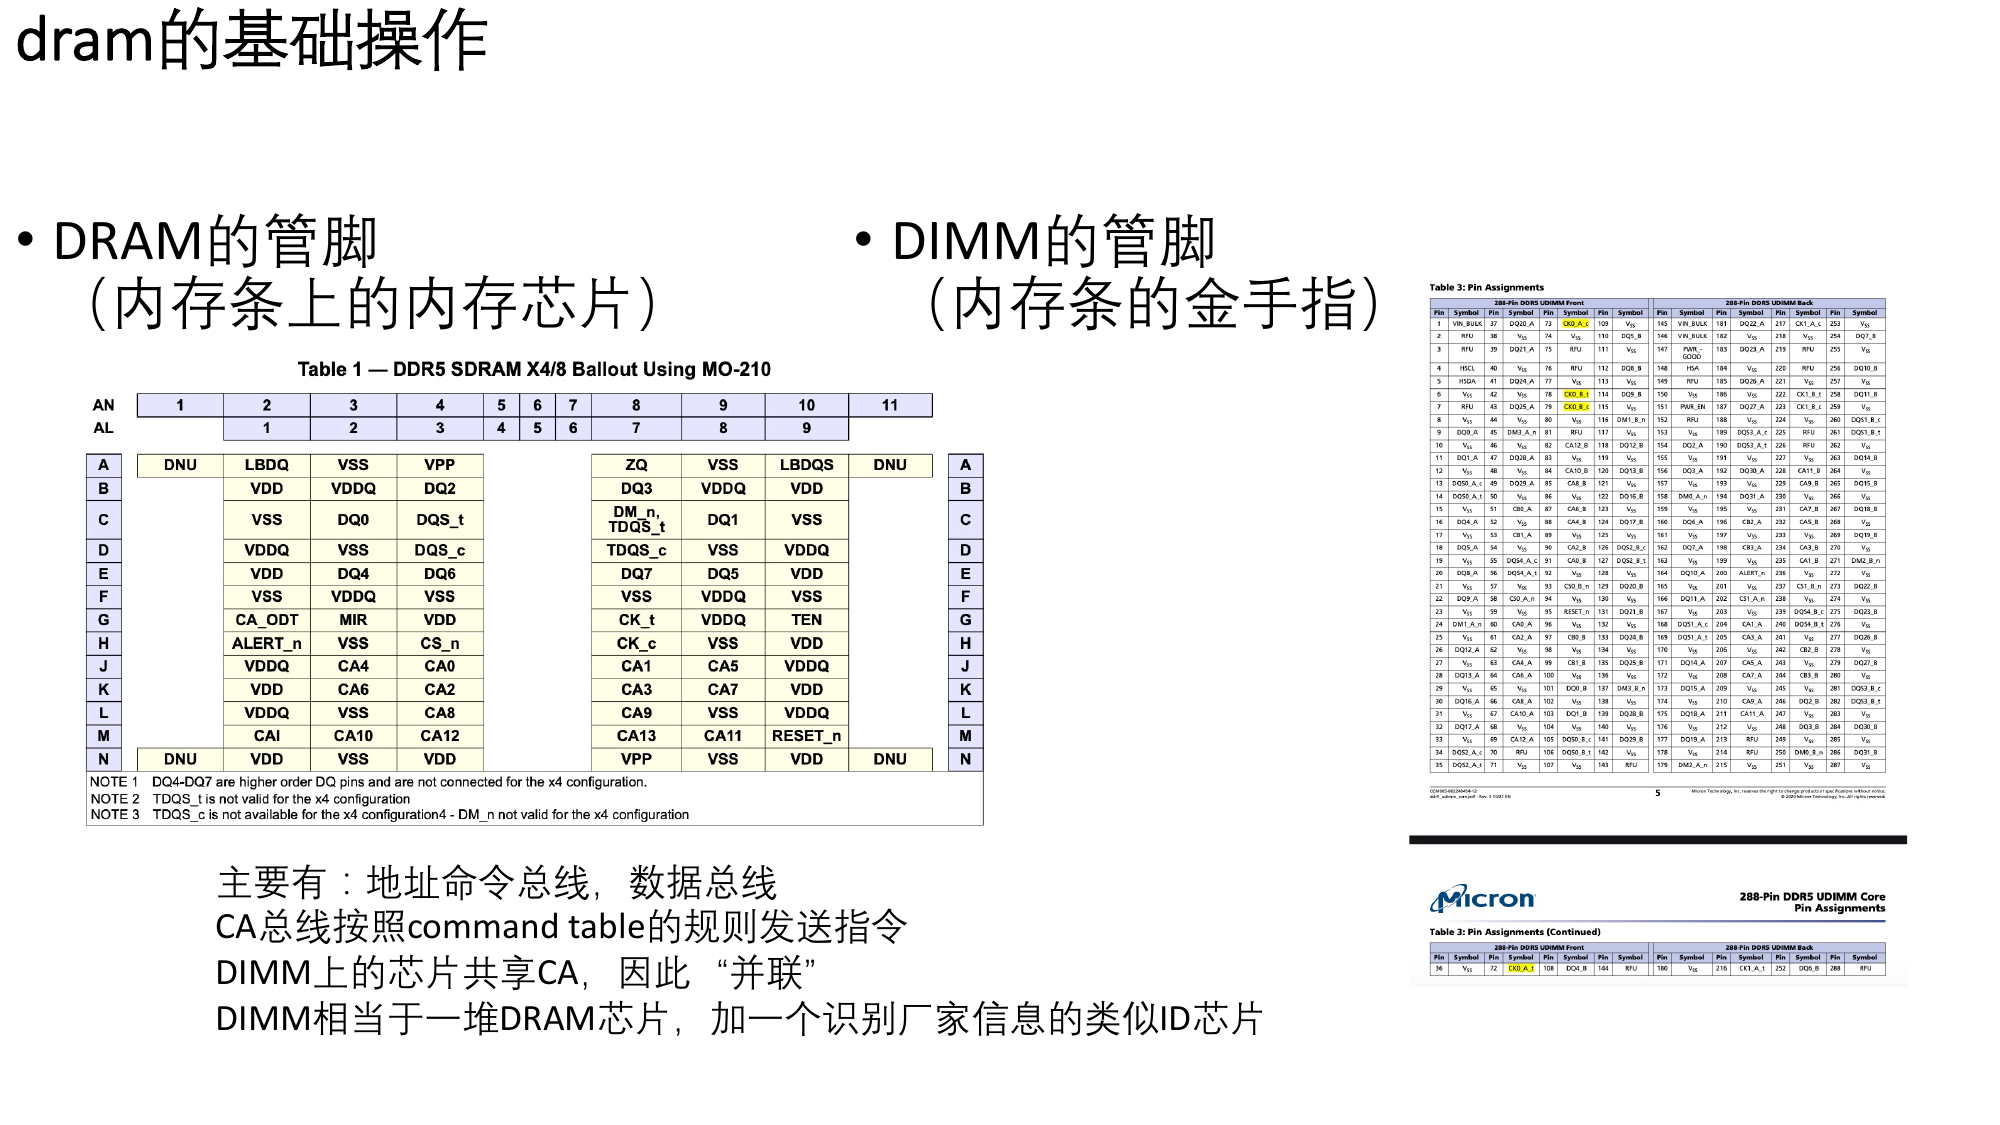
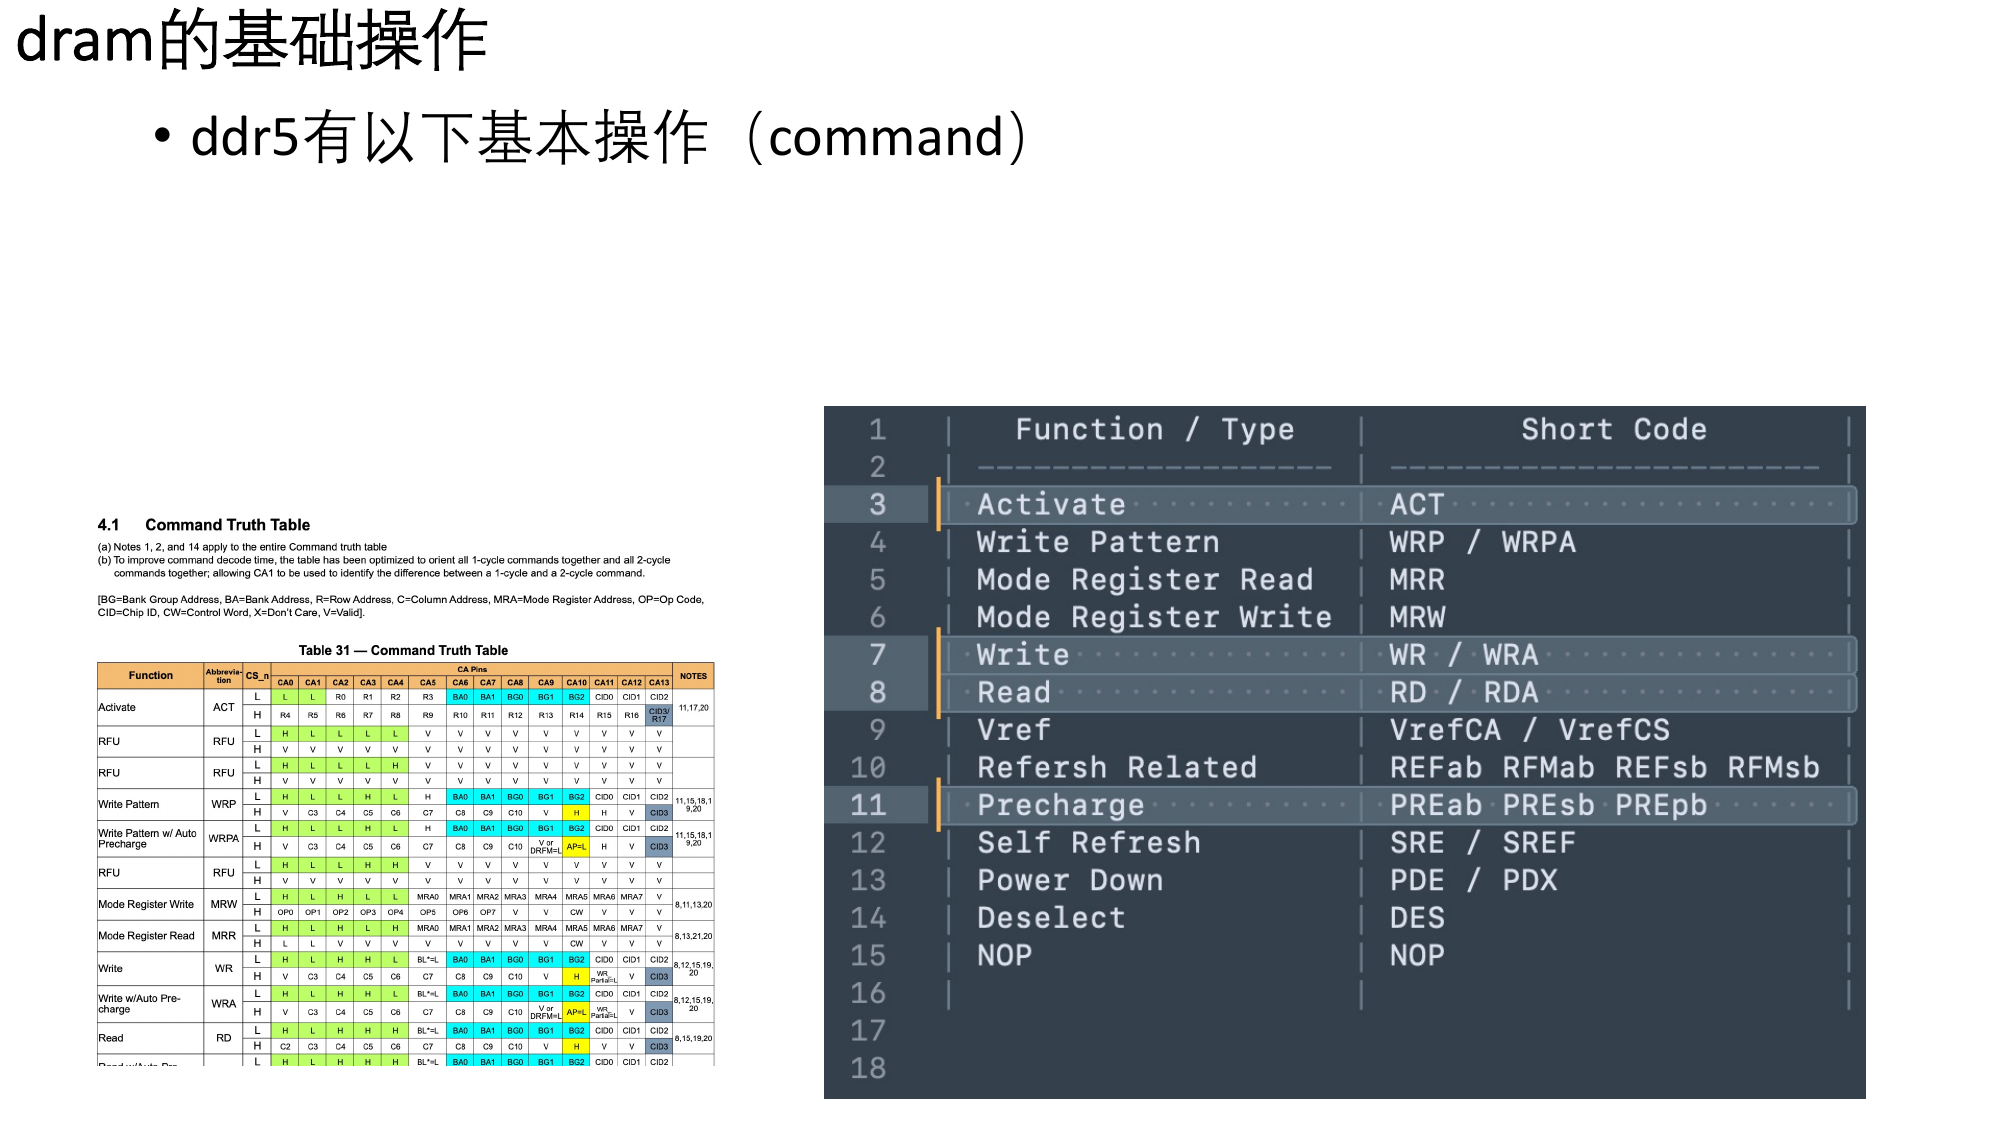
DRAM 芯片的管脚主要是地址命令总线(CA)与数据总线(DQ),DIMM 上的多颗芯片共享 CA,因此彼此是“并联”关系;CA 总线按照标准中的 command table 发送指令,DIMM 相当于一堆 DRAM 芯片外加一颗识别厂家信息的 ID 芯片。DDR5 的基本命令包括 Activate(ACT)、Read(RD/RDA)、Write(WR/WRA)、Precharge(PRE)、Refresh(REF/RFM)、Mode Register 读写(MRR/MRW)、Power Down(PDE/PDX)、Self Refresh(SRE)等。
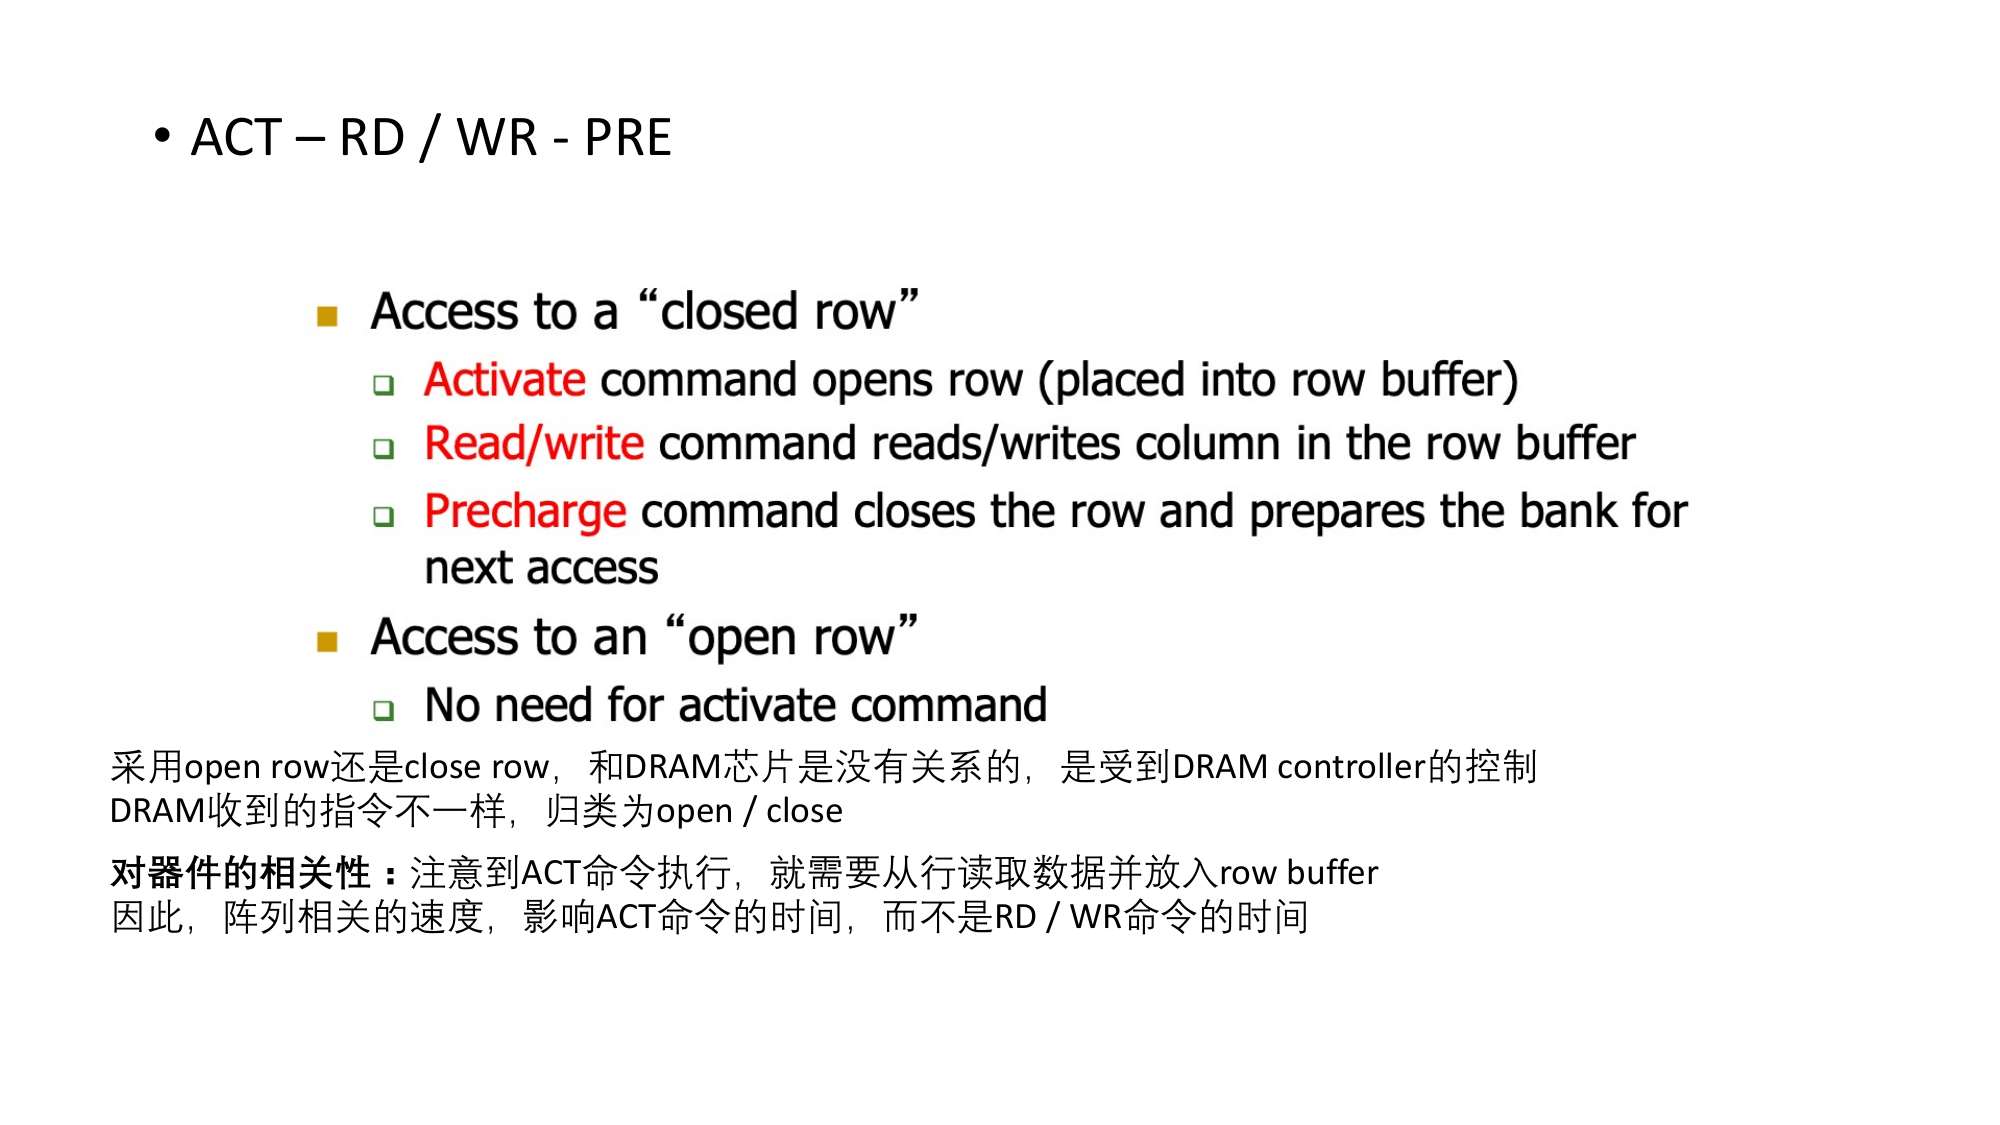
一次典型的读写周期可以概括为 ACT – RD/WR – PRE:先激活目标行,把数据从阵列读入 Sense Amplifier(即行缓冲 row buffer);随后执行读或写;最后 Precharge 关闭已打开的行。这里有两个容易被忽略的要点:其一,采用 open row 还是 close row 策略由 DRAM 控制器决定,与芯片本身无关;其二,ACT 命令需要真正从存储阵列读出数据并放入 row buffer,因此阵列本身的速度影响的是 ACT 的时间,而不是 RD/WR 的时间——这个结论在后面的延迟分析中还会用到。
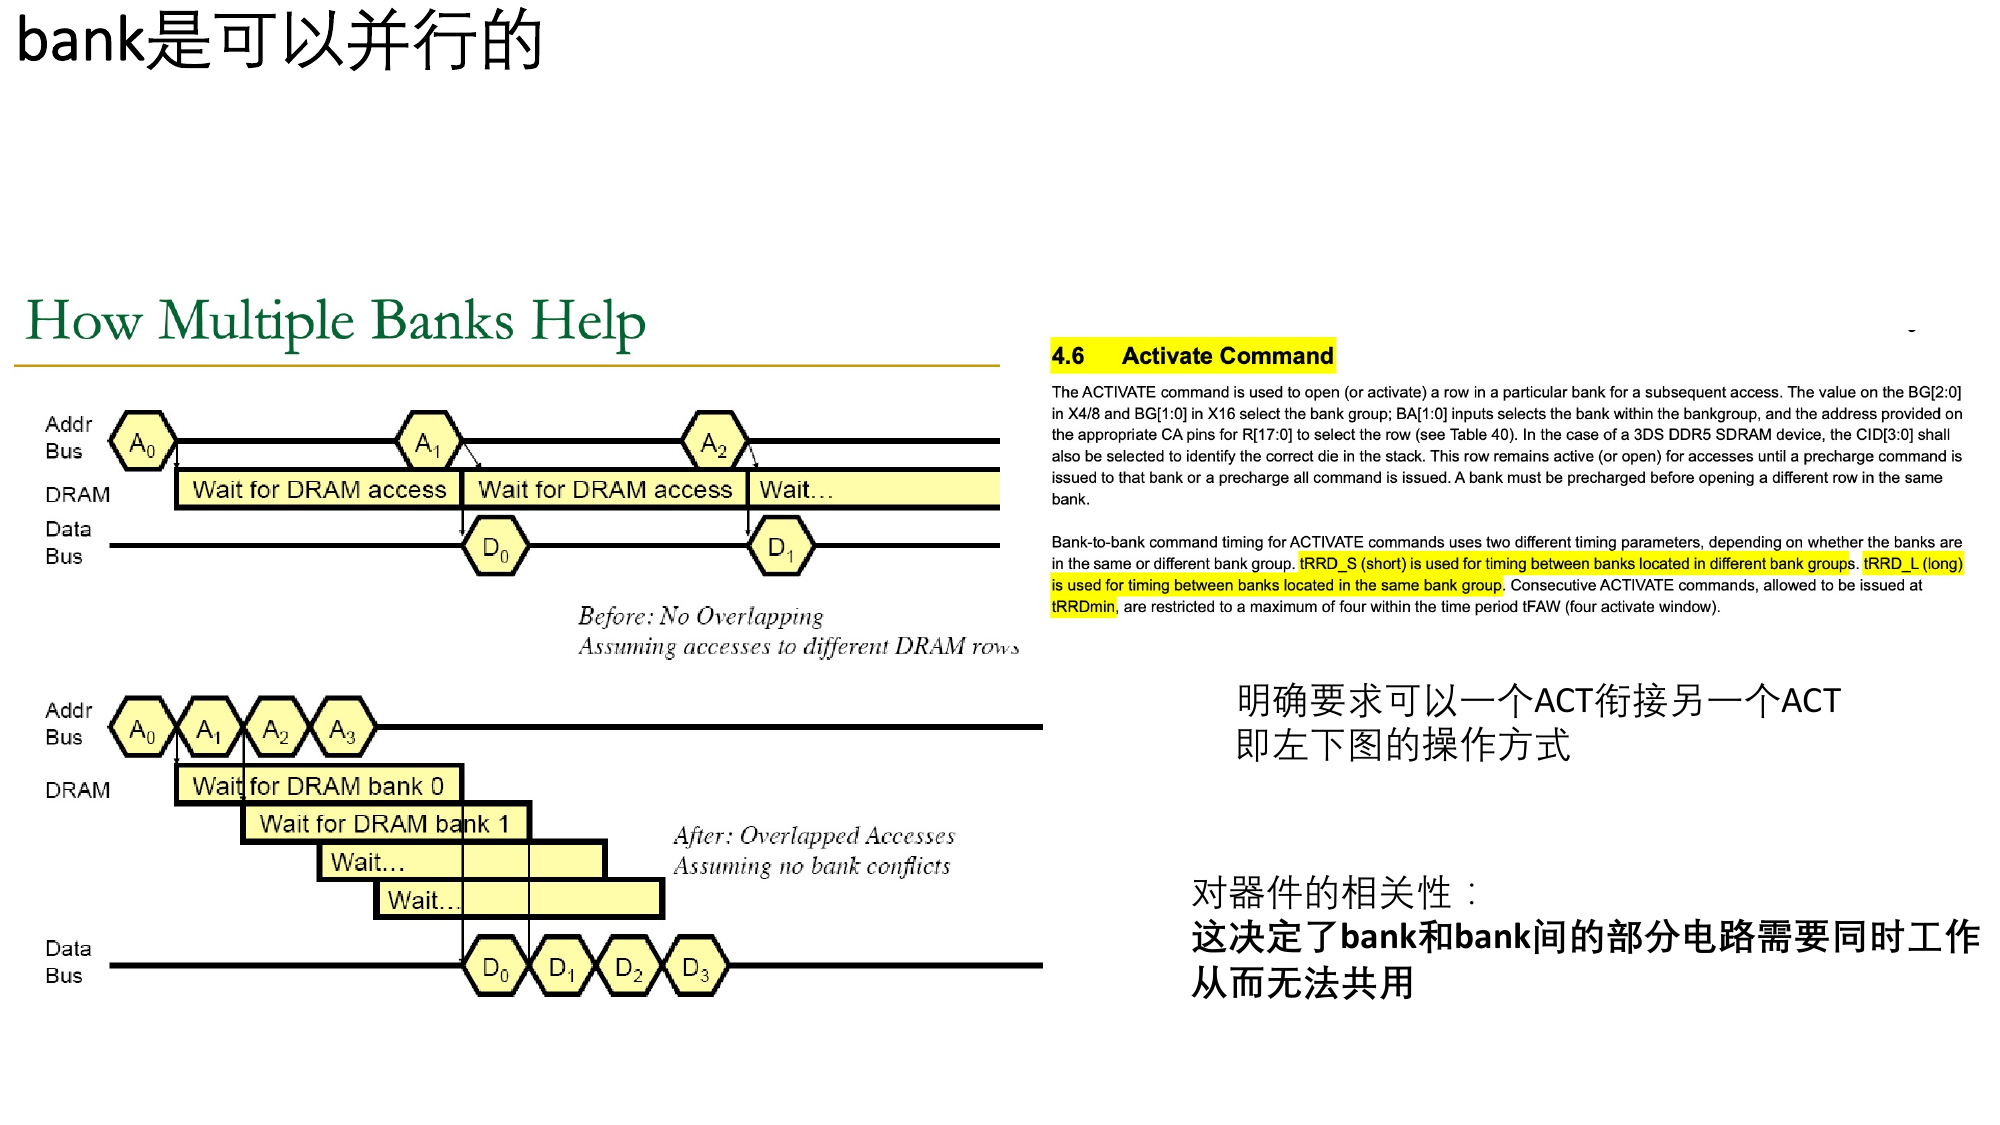
标准明确允许一个 ACT 紧接着另一个 ACT,即不同 Bank 可以并行操作。这意味着多个 Bank 的部分电路需要同时工作,彼此之间无法共享——这也是理解后续各标准多通道设计的一把钥匙。
先看各标准当前主流版本的文档编号与发布时间,便于建立整体印象。
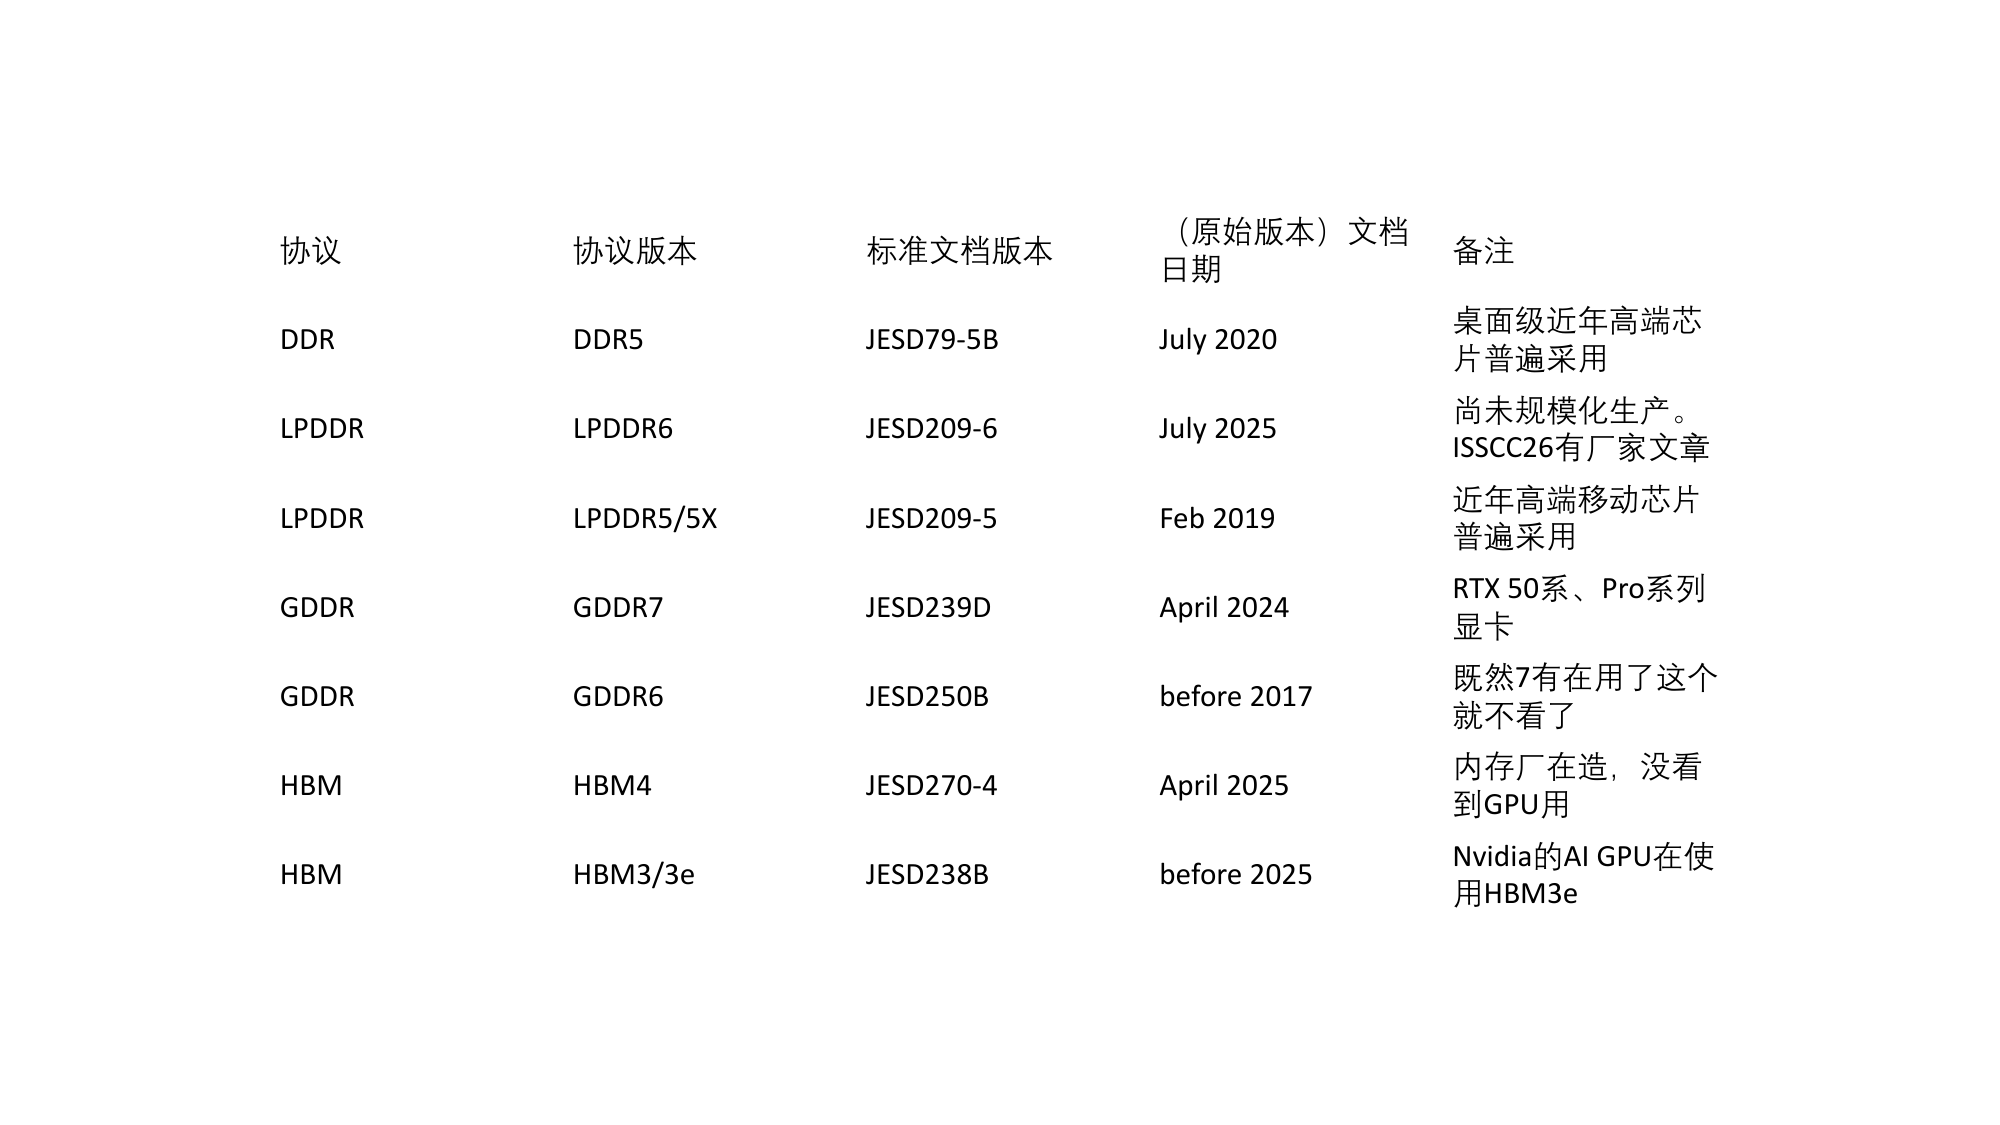
| 协议 | 版本 | 标准文档 | 发布日期 | 备注 |
|---|---|---|---|---|
| DDR | DDR5 | JESD79-5B | 2020-07 | 近年桌面级高端芯片普遍采用 |
| LPDDR | LPDDR6 | JESD209-6 | 2025-07 | 尚未规模化生产,ISSCC 2026 已有厂家文章 |
| LPDDR | LPDDR5/5X | JESD209-5 | 2019-02 | 近年高端移动芯片普遍采用 |
| GDDR | GDDR7 | JESD239D | 2024-04 | RTX 50 系、Pro 系列显卡使用 |
| GDDR | GDDR6 | JESD250B | 2017 之前 | GDDR7 已在用,未展开 |
| HBM | HBM4 | JESD270-4 | 2025-04 | 内存厂商在制造,尚未见 GPU 采用 |
| HBM | HBM3/3e | JESD238B | 2025 之前 | Nvidia AI GPU 正使用 HBM3e |
DDR 是内存中的“经典产物”,面向通用计算场景。容量方面,单颗芯片最高可达 64 Gbit。带宽由“频率 × 并行通道数”决定:常用频率 3600~5600 MT/s,服务器可达 6400 MT/s 以上;单芯片 DQ 宽度有 x4/x8/x16,更高层级上一个 Channel 为 64 位宽,消费级 CPU 通常两个 Channel,服务器最多可达 12 个(CA 宽度 14 位,仅作记录)。
延迟方面,标准按 tRCD + tAA 描述:tRCD 是 Activate 到 Read/Write 命令的延迟,tAA 是 Read 命令到首拍数据的延迟,几乎与 tCAS 同义。这两个指标以 ns 计,且基本与速度档位无关:tRCD 通常在 14+、16+、17.5+ ns(标准未规定上限),tAA 则在 1422.2、1622.2、17.5~22.2 ns 之间。功耗方面,标准罗列了很多电流指标,但并未规定具体数值(参考真实数据手册,各电流在几十到几百毫安);只看电压的话,VDD/VDDQ 为 1.1V,VPP 为 1.8V。其中 VDD/VDDQ 对应逻辑与 I/O,VPP 用于开启字线,以避免 1T1C 单元中访问晶体管阈值损失带来的问题。备注中还补充了一个细节:DDR 的 I/O 并非 CMOS 全摆幅电路,而是为高速专门优化的设计。
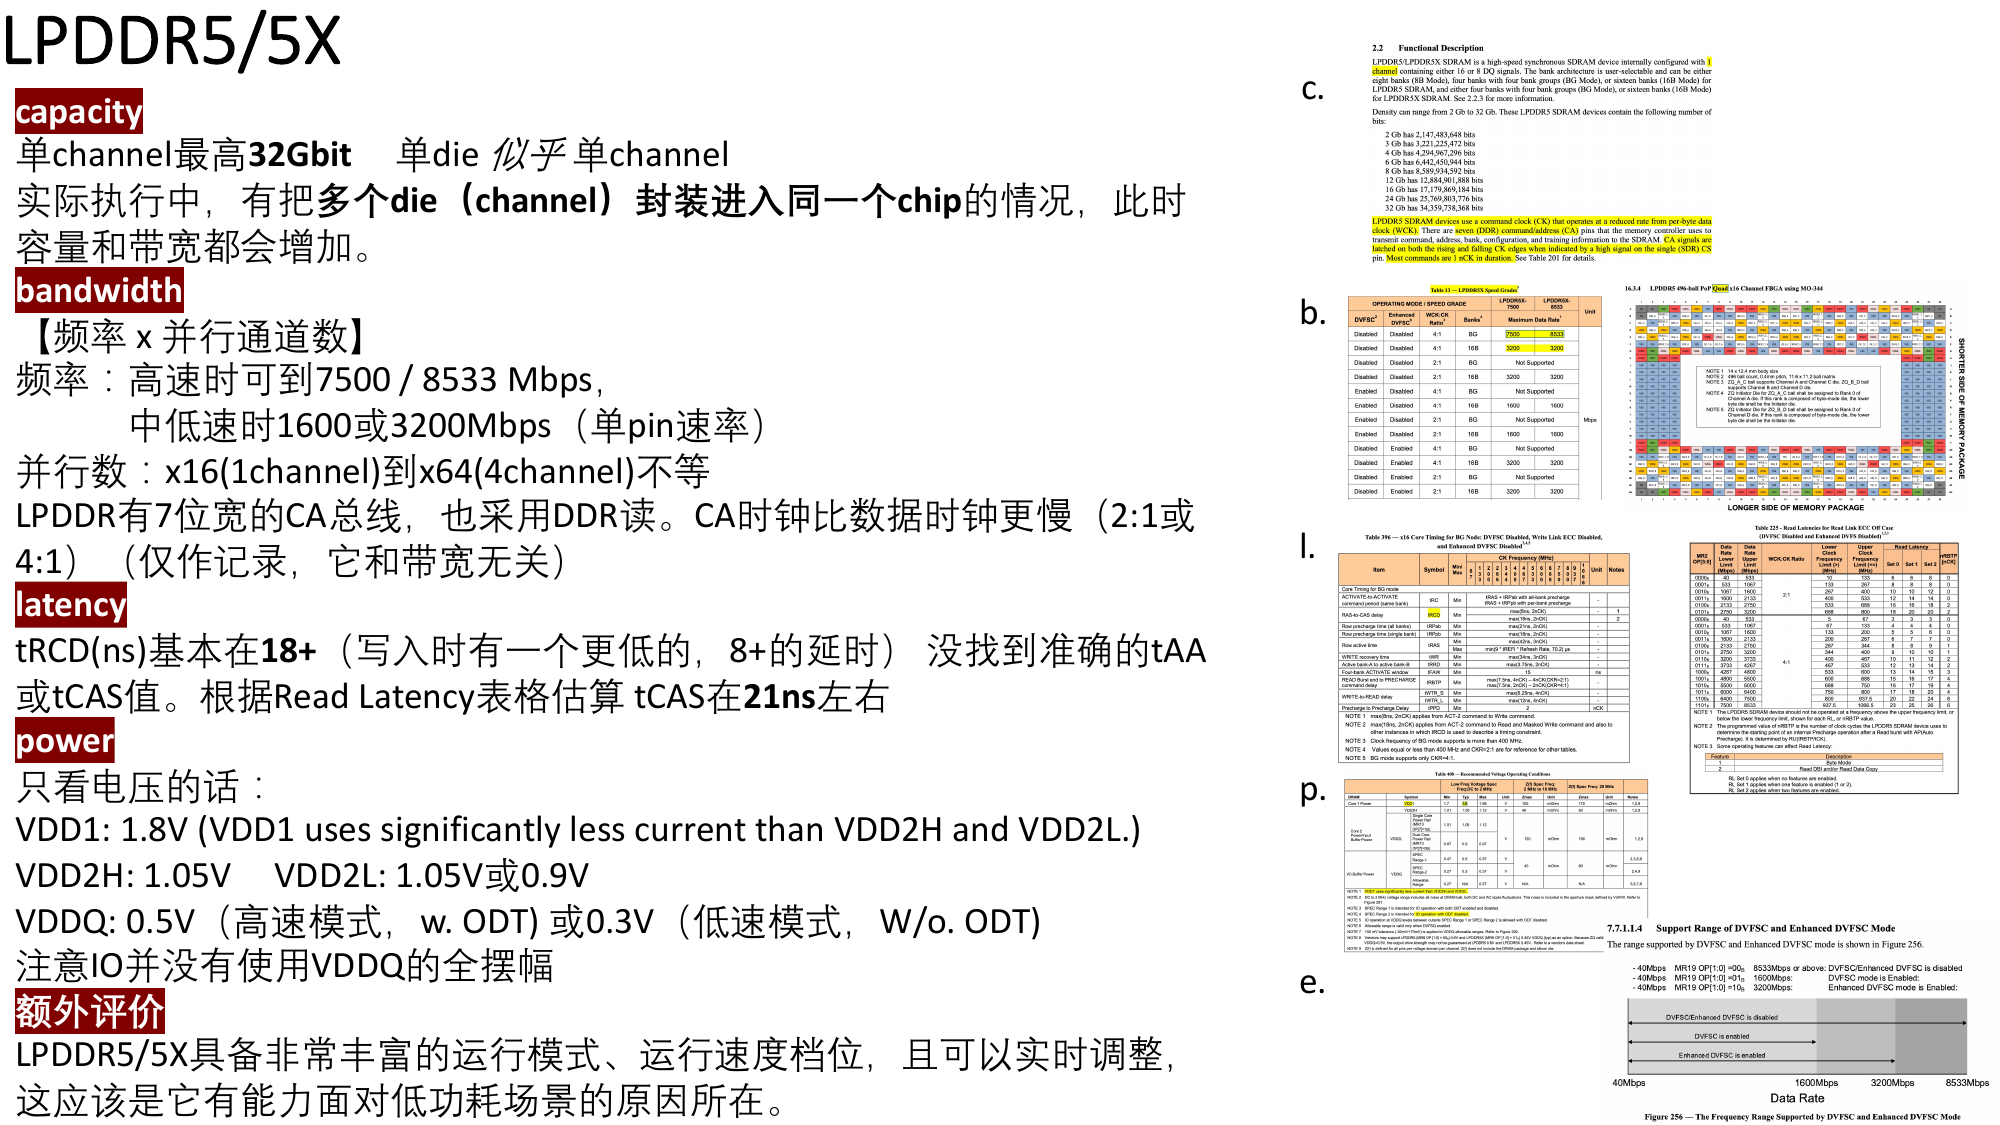
LPDDR 面向移动设备,核心诉求是低功耗。容量上,单 Channel 最高 32 Gbit,单 die 通常对应单 Channel;实际产品中也有把多个 die(Channel)封装进同一颗芯片的做法,此时容量和带宽同步增加。带宽同样由“频率 × 并行通道数”决定:高速时单 pin 可达 7500/8533 Mbps,中低速时则为 1600/3200 Mbps;并行宽度从 x16(1 Channel)到 x64(4 Channel)不等。LPDDR 的 CA 总线只有 7 位宽,采用 DDR 读,CA 时钟比数据时钟更慢(2:1 或 4:1)。
延迟方面,tRCD 基本在 18+ ns(写入路径有一个更低的 8+ ns 延迟),标准中未直接给出 tAA/tCAS,按 Read Latency 表格估算,tCAS 在 21 ns 左右。功耗控制是 LPDDR 的强项:电压分为 VDD1 1.8V(电流显著小于其他电源)、VDD2H 1.05V、VDD2L 1.05V 或 0.9V,以及 VDDQ 0.5V(高速模式、带 ODT)或 0.3V(低速模式、不带 ODT);同样,I/O 并不使用 VDDQ 的全摆幅。备注中还提到一个省电细节:高频 WCK 时钟在不需要传输数据时会直接关闭。
LPDDR5/5X 拥有非常丰富的运行模式和速度档位,并且可以实时调整——这正是它能从容应对低功耗场景的原因。一个有力的佐证来自实际产品:Apple M5 Max 芯片内部真实集成了 32 个 LPDDR5X Channel,对应 128 GB 容量、614 GB/s 带宽,说明 LPDDR 在高性能内存系统中已经完全不逊于传统 DDR。
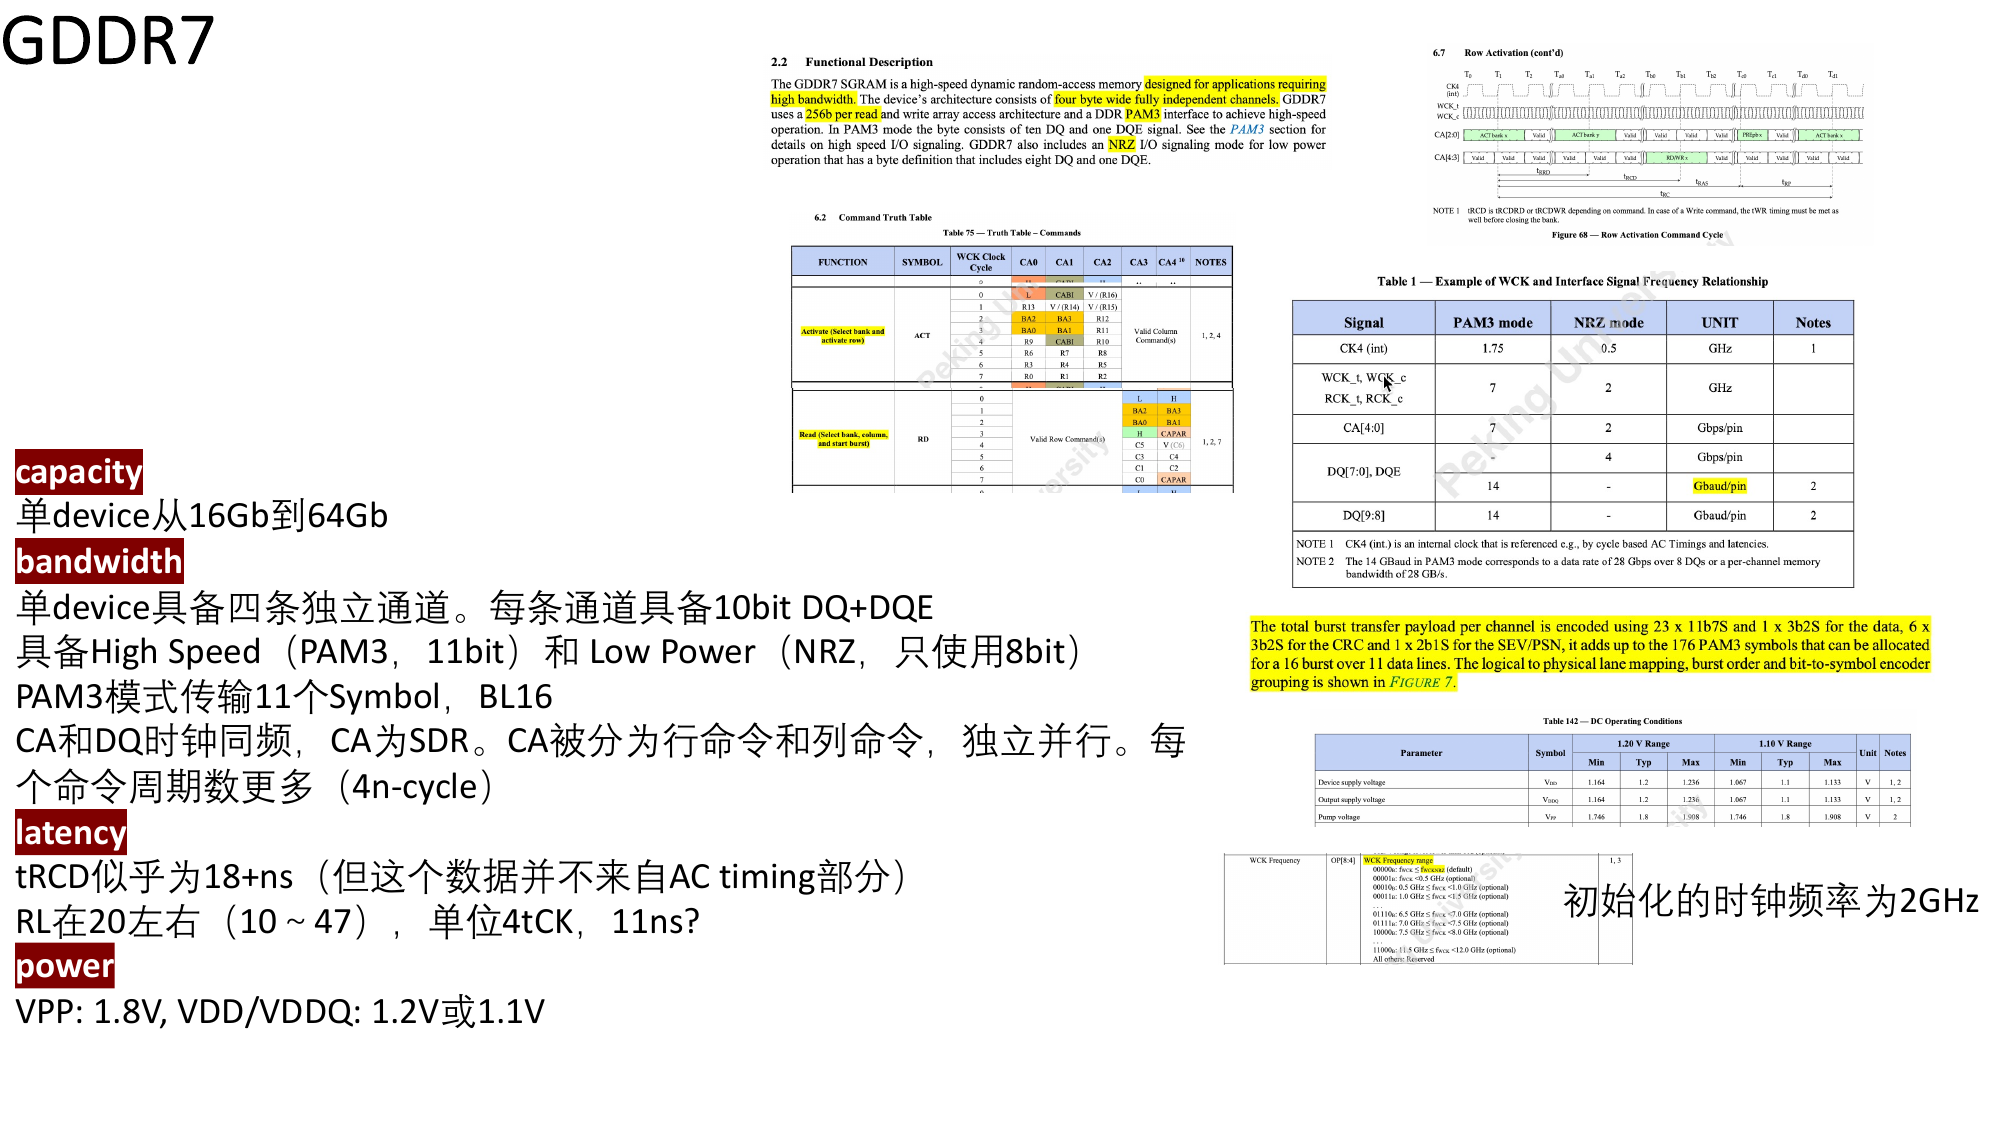
GDDR 是显卡专用内存,设计目标就是高带宽。容量上,单 device 从 16 Gb 到 64 Gb。带宽设计相当激进:单 device 拥有四条独立通道,每条通道具备 10 bit DQ + DQE;I/O 分为 High Speed(PAM3,11 bit)和 Low Power(NRZ,8 bit)两种模式,PAM3 模式下一次突发传输 16 个 Symbol(BL16)。GDDR7 的 CA 与 DQ 同频,CA 为 SDR 采样,并把行命令与列命令分成两套独立并行发送——代价是每个命令需要更多周期(4n-cycle),换来的是命令带宽的优化;芯片初始化时时钟频率为 2 GHz。
延迟方面,tRCD 似乎为 18+ ns(该数据并非来自 AC timing 部分),RL 在 20 左右(范围 10~47,单位 4tCK),换算约 11 ns。功耗方面电压偏高:VPP 1.8V,VDD/VDDQ 1.2V 或 1.1V,因此整体功耗相对较大。备注中还提到,GDDR7 每次阵列读/写访问的数据量为 256 bit(PAM3 下 burst 16 symbol,NRZ 下 32 word)——这正是高带宽的底层来源之一。
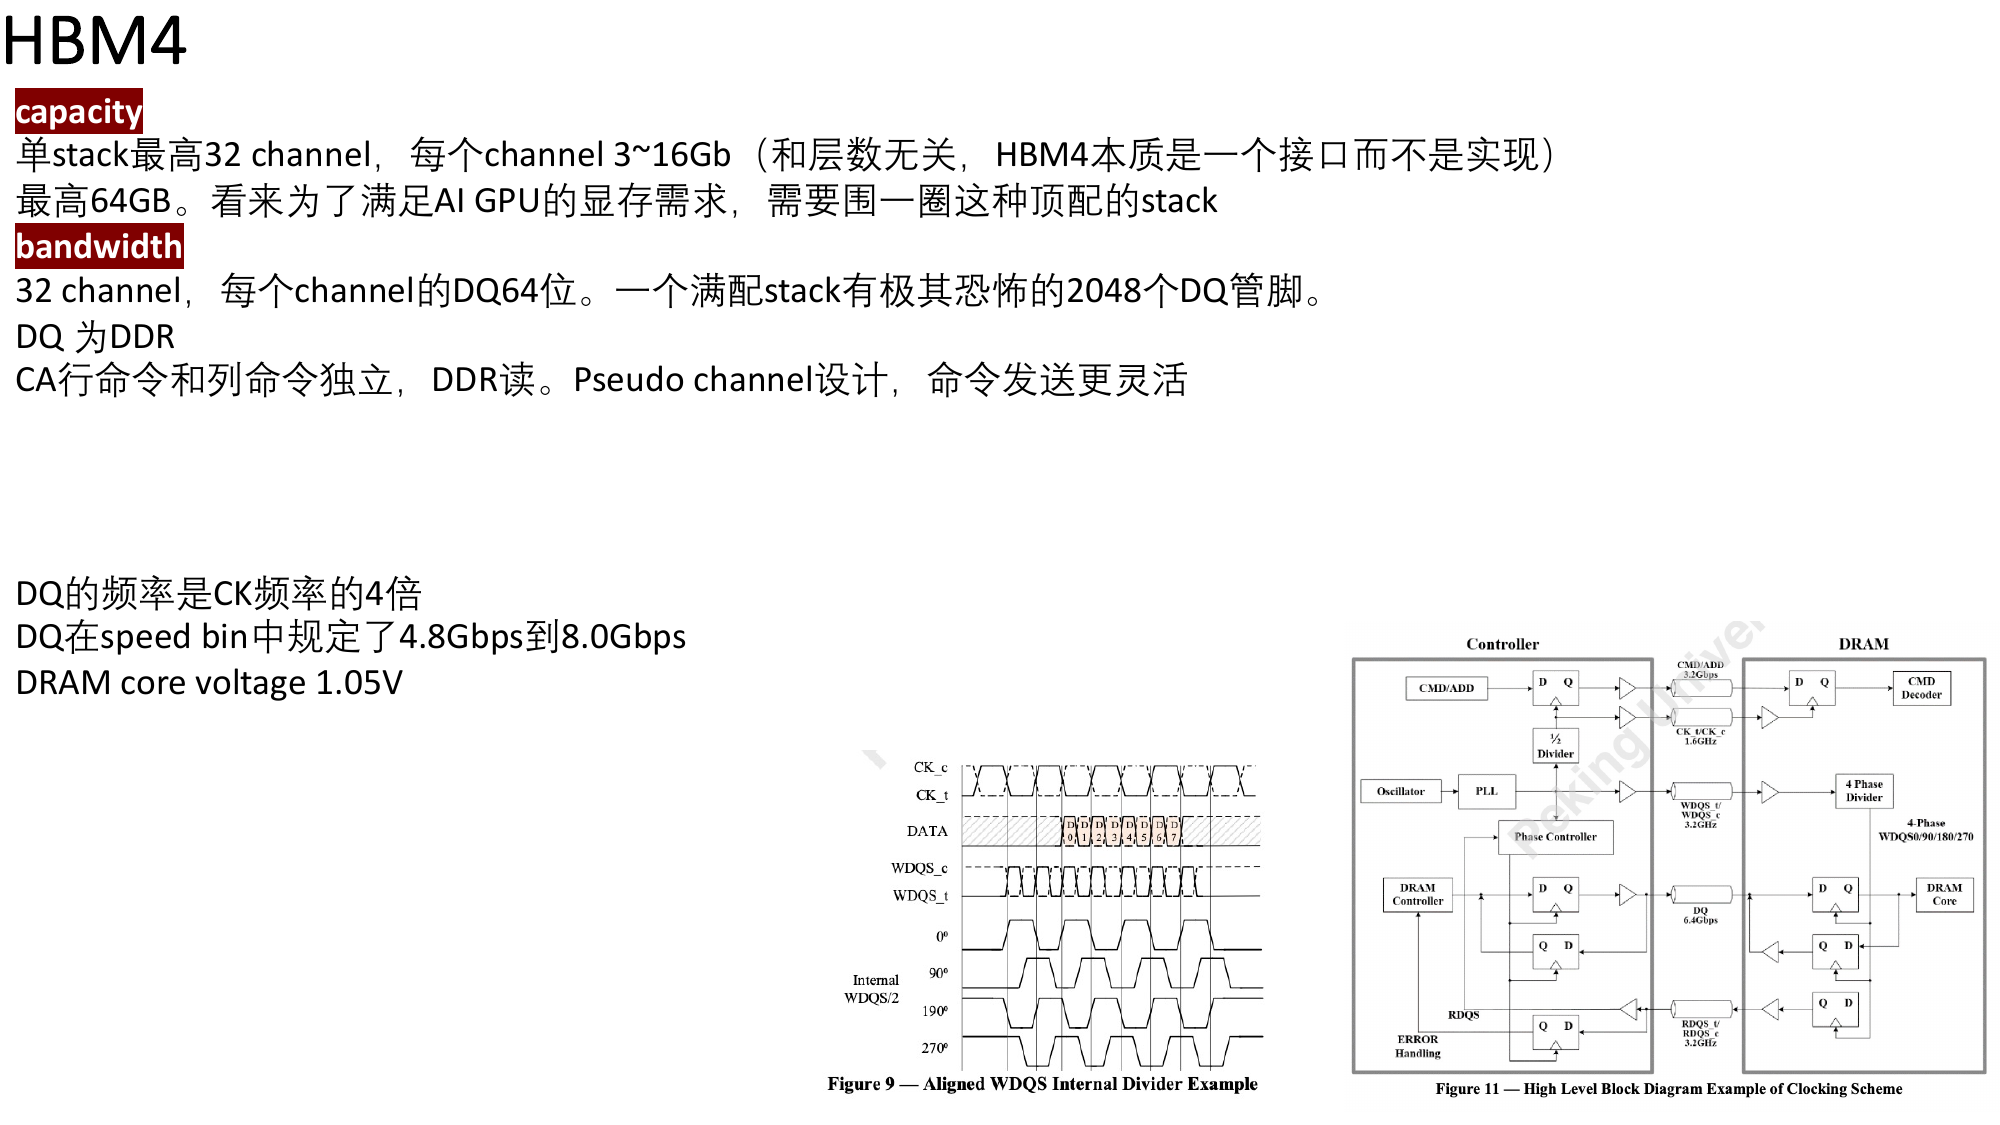
HBM 走的是另一条路:不追求极限速率,而是用先进封装把大量 DQ 接口“堆”出来。容量上,单个 Stack 最高支持 32 个 Channel,每个 Channel 3~16 Gb(与层数无关——HBM4 本质上定义的是一个接口而非具体实现),满配可达 64 GB;为满足 AI GPU 的显存需求,需要围绕计算芯片排一圈这样的顶配 Stack。带宽上,32 Channel × 每 Channel 64 位 DQ,意味着一个满配 Stack 有 2048 个 DQ 管脚,规模极其庞大。HBM4 的 DQ 为 DDR 传输,行、列命令独立,还引入了 Pseudo Channel 设计,命令发送更灵活;DQ 频率是 CK 频率的 4 倍,速度档位规定在 4.8~8.0 Gbps,而 DRAM core 电压只有 1.05V。
把四种标准放在一起,特点非常鲜明:
| 维度 | DDR5 | LPDDR5/5X | GDDR7 | HBM4 |
|---|---|---|---|---|
| 定位 | 通用计算 | 移动/低功耗 | 图形/高带宽 | AI/高带宽 + 先进封装 |
| 通道特点 | Channel 宽,容量扩展性好 | 通道窄,靠堆通道数 | 多通道,单通道容量小 | 通道极多,DQ 管脚海量 |
| 速率策略 | 中速,CA 命令短 | 可变频率,低频极低、高频不差 | 极高,PAM3 进一步提速 | 速率不算极限,靠 DQ 数量 |
| 延迟 | tRCD 14+ ns,tAA 14~22.2 ns | tRCD 18+ ns,tCAS 约 21 ns | tRCD 18+ ns,RL 约 11 ns | 与其它标准量级相近 |
| 功耗 | VDD 1.1V,常规 | 多档电压,最低 VDDQ 0.3V | 电压偏高,功耗较大 | 低电压、低速率、无 ODT |
原演示文稿的总结颇为精炼:
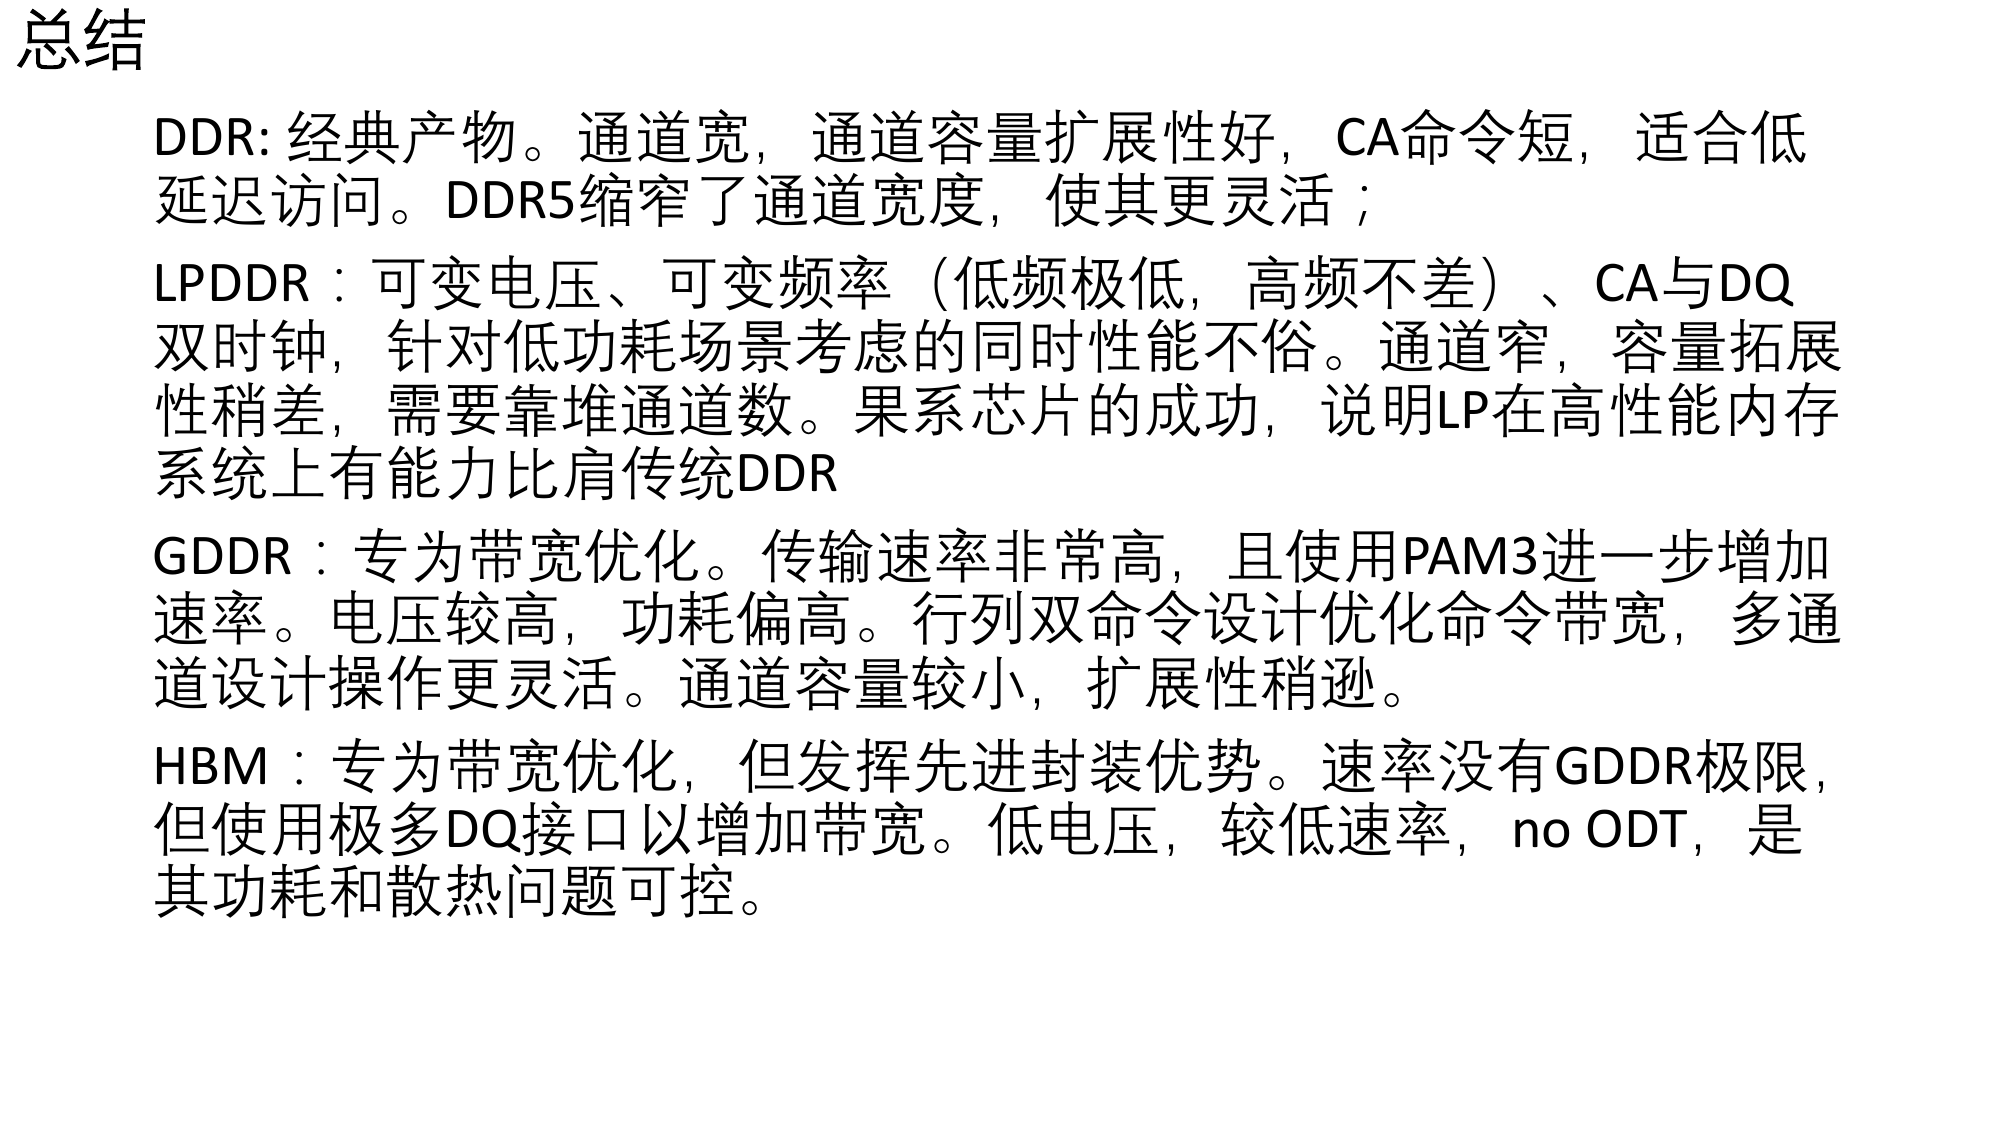
Prefetch 代表一次从 DRAM 阵列取出多少数据,之后这些数据以 burst 的方式输出。HBM 和 GDDR 明确为 256 bit;DDR5 是 16n(n 为 DQ 宽度,例如 x8 芯片即 128 bit);LPDDR 则是 16n 或 32n。这个数字直接决定了“阵列内部访问一次”能喂给接口多少数据,是理解各标准带宽设计的关键参数。
On-Die Termination(片上终端)是多个标准中反复出现的关键词:终端电阻用于高速传输线的阻抗匹配。有趣的是,HBM4 标准明确表明 “Unterminated”。这至少说明三点:其一,接口速率不算太快,不需要严格的阻抗匹配;其二,HBM 的连线极短——即便 LPDDR 和 GDDR 也紧贴计算单元,但仍要经过 PCB 或其它基板,而 HBM 与计算单元是共同封装在硅片上的;其三,省去电阻直接带来了功耗优化。
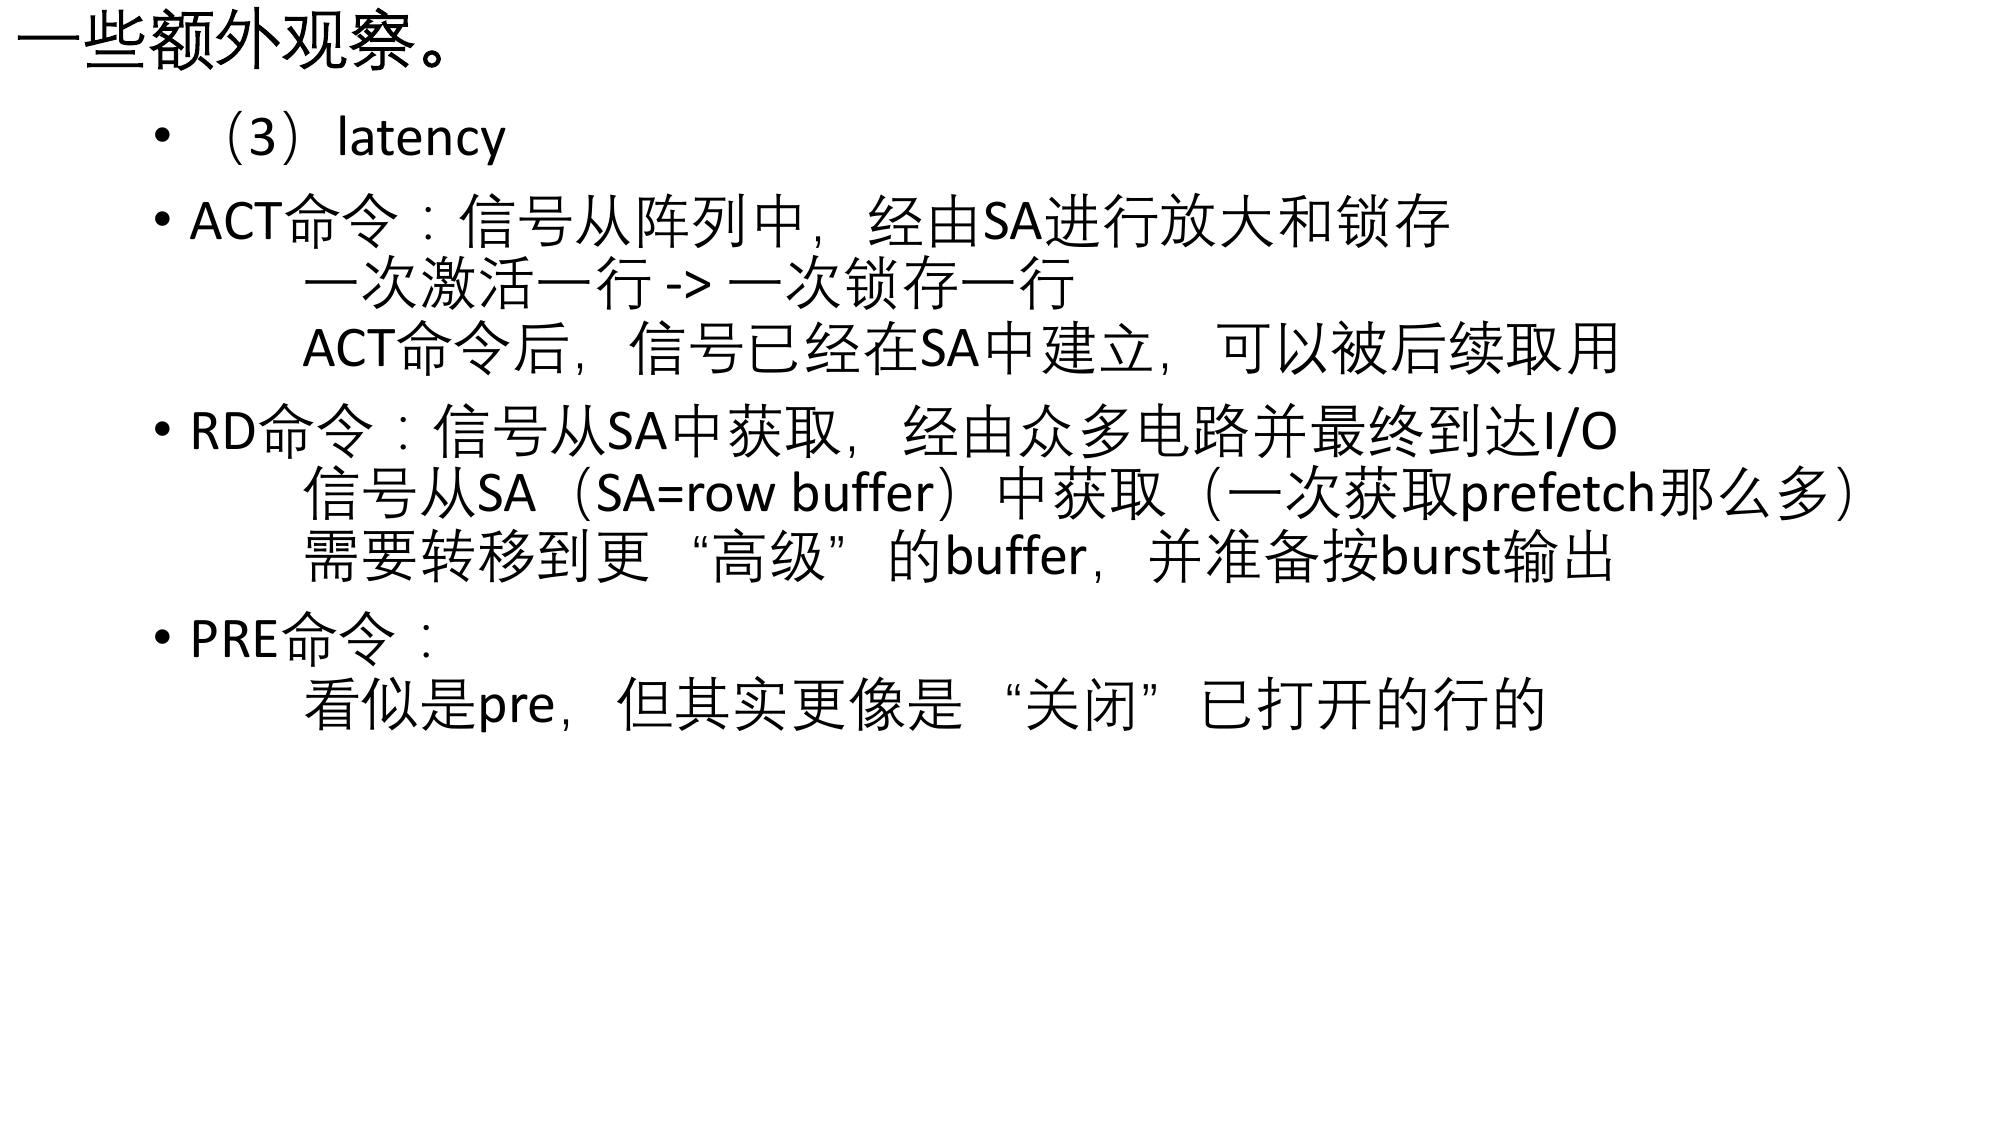
一次读操作的时间可以拆成两段:ACT 命令把信号从阵列读出,经 Sense Amplifier 放大并锁存,完成“一次激活一行、一次锁存一行”,之后信号已在 SA 中建立,可被后续取用;RD 命令则从 SA(即 row buffer)中取出一个 prefetch 宽度的数据,转移到更高一级的缓冲,并按 burst 方式输出;PRE 看似“pre”,实际作用是关闭已打开的行。
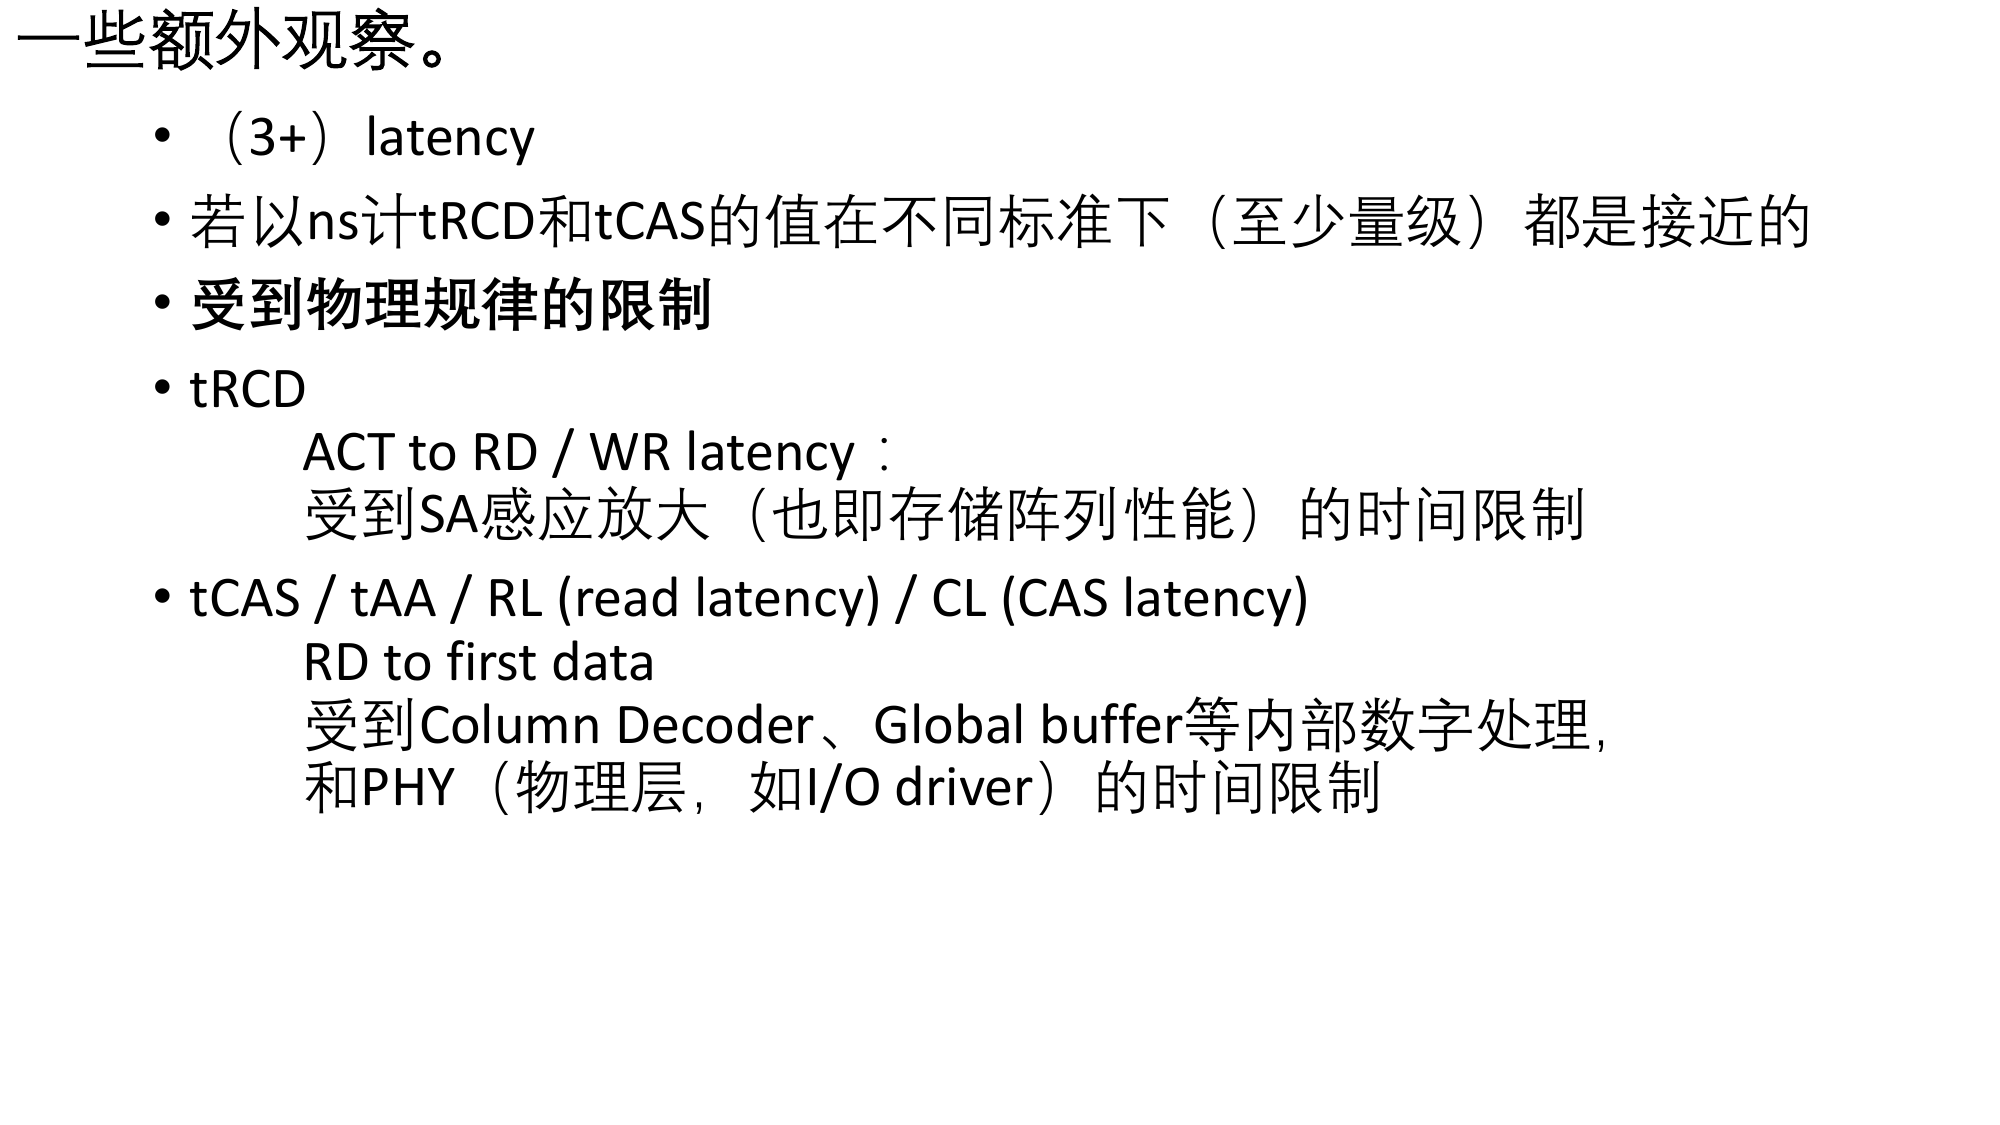
若以 ns 计,不同标准下的 tRCD 和 tCAS 在量级上都是接近的——这背后是物理规律的限制。tRCD(ACT 到 RD/WR)受 Sense Amplifier 感应放大(即存储阵列性能)的时间限制;tCAS/tAA/RL/CL(RD 到首拍数据)则受列译码器、全局缓冲等内部数字处理,以及 PHY(如 I/O driver)的时间限制。备注中还解释了这两个名称的来源:tRCD 即 RAS to CAS delay,RAS(Row Address Strobe)对应发送行地址的时刻;如今命令与地址已经合二为一,RAS 即 ACT 命令(同时指定开启哪一行),CAS 即 RD 命令(同时指定开启哪一列)。
四种标准没有绝对的优劣,只有不同的取舍:DDR 胜在通用与低延迟,LPDDR 胜在低功耗与灵活调度,GDDR 把带宽推向极致,HBM 则用先进封装换来了容量与功耗的平衡。理解了 Channel/Bank、prefetch、ODT 和 tRCD/tCAS 这些概念之后,再回头看各家规格书,会发现差异其实都围绕同一组物理问题展开。